
Wiedza
DAISY STUDIO. Projekt, który powstał przez przypadek, waży 422 GB i prawdopodobnie nigdy się nie skończy.
W tym artykule
Nie planowałem budować własnego studia sztucznej inteligencji.
Naprawdę.
Nie miałem przygotowanego harmonogramu, dokumentacji projektowej ani rozpisanej listy funkcjonalności. Nie siedziałem przed komputerem z zamiarem stworzenia kolejnej aplikacji. Nie planowałem nawet, że pewnego dnia napiszę o tym Case Study.
Wszystko zaczęło się tak, jak zaskakująco wiele projektów w DIGIKROM.
Przez przypadek.
Chciałem sprawdzić możliwości lokalnych modeli sztucznej inteligencji generujących obrazy. Zobaczyć, ile można wycisnąć ze współczesnego sprzętu, jak bardzo rozwinęły się otwarte narzędzia i czy istnieje sensowna alternatywa dla popularnych generatorów działających w chmurze.
Jedno pytanie prowadziło do następnego. Jeden model do kolejnego. Jeden eksperyment kończył się odkryciem, które wymagało następnego eksperymentu.
Aż w pewnym momencie zorientowałem się, że nie testuję już pojedynczego programu.
Buduję własne studio AI.
I co zabawne, wszystko wskazuje na to, że właśnie zacząłem projekt, którego prawdopodobnie nigdy nie uznam za ukończony.
DAISY STUDIO. Dlaczego właśnie tak?
Zacznę od rzeczy najważniejszej: ten projekt od samego początku ma konkretnego odbiorcę.
Jest nim moja żona, Dorota.
To właśnie dla niej powstaje DAISY STUDIO.
Roboczo cały system funkcjonuje pod nazwą DIGIKROM AI STUDIO. Tak nazywa się jego techniczna część, tak rozwijam aplikację i tak identyfikuję kolejne wersje. Ale DAISY STUDIO znacznie lepiej oddaje ideę, od której wszystko się zaczęło.
Dora ma móc tworzyć obrazy, eksperymentować z fotografią, odnawiać stare zdjęcia i korzystać z zaawansowanych modeli AI. Nie powinna jednak musieć uczyć się całej technicznej infrastruktury, która za tym stoi.
Nie musi wiedzieć, czym jest sampler, scheduler, latent, VAE, LoRA czy model dyfuzyjny. Nie musi rozumieć połączeń pomiędzy węzłami ani zastanawiać się, dlaczego niewłaściwie skonfigurowany workflow odmawia współpracy.
Ma otworzyć przeglądarkę, opisać swój pomysł i kliknąć przycisk.
To technologia ma dostosować się do człowieka, a nie człowiek do technologii.
Ten jeden warunek od początku był dla mnie ważniejszy niż liczba funkcji czy możliwości konfiguracji.
Najpierw był ComfyUI. I bardzo dużo przewodów.
Jeśli ktoś pracował z ComfyUI, doskonale wie, o czym mówię.
To niezwykle potężne środowisko pozwalające budować własne procesy generowania i przetwarzania obrazów. Jednocześnie jego interfejs potrafi wyglądać jak schemat elektryczny urządzenia, którego instrukcję zgubił konstruktor.
Każdy element odpowiada za określoną operację. Modele trzeba poprawnie załadować, połączyć, skonfigurować i dostosować do posiadanej pamięci GPU. Do tego dochodzą dodatkowe węzły, zależności, biblioteki, wersje Pythona i okazjonalne błędy, które pojawiają się dokładnie wtedy, kiedy człowiek jest przekonany, że wszystko już działa.
Na początku właśnie tam spędzałem większość czasu.
Testowałem kolejne modele, porównywałem ich zachowanie, sprawdzałem jakość generowanych fotografii, anatomii postaci, tekstu, materiałów i złożonych scen.
Nie interesowało mnie wyłącznie to, czy wygenerowany obraz będzie ładny.
Chciałem wiedzieć, czy model rozumie polecenie. Czy potrafi prawidłowo przedstawić dłonie. Czy zachowuje logiczne relacje pomiędzy obiektami. Czy zdjęcie produktu ma prawidłową konstrukcję. Czy napis, o który proszę, faktycznie pojawia się na obrazie.
I tu zaczęła się właściwa zabawa.
Trzy ręce, dodatkowa wojowniczka i zegarek marki CRITICAL.
Niektóre eksperymenty zapamiętam na długo.
Podczas jednego z testów generowałem scenę lutnika naprawiającego gitarę elektryczną. Obraz miał wyglądać jak realistyczna fotografia dokumentalna: warsztat, deszcz za oknem, ciepłe światło lampy, instrument na stole i mechanik wykonujący precyzyjną czynność.
Porównywałem wyniki różnych narzędzi. Jeden z obrazów na pierwszy rzut oka wyglądał bardzo atrakcyjnie.
Problem polegał na tym, że jego bohater miał trzy ręce.
Przy innym eksperymencie poprosiłem o skomplikowaną scenę walki samuraja z tygrysem. Model stworzył widowiskową ilustrację pełną ruchu i szczegółów.
A przy okazji postanowił dorzucić wojowniczkę, o którą nikt nie prosił.
Jeszcze ciekawiej zrobiło się przy fotografii luksusowego zegarka. Chciałem poprawić zgodność generacji z instrukcjami, więc dodałem na początku promptu nagłówek „CRITICAL REQUIREMENTS”.
Model rzeczywiście potraktował to bardzo poważnie.
Tak poważnie, że umieścił słowo CRITICAL bezpośrednio na tarczy zegarka.
Po usunięciu nagłówka problem zniknął.
Te sytuacje są zabawne, ale mają duże znaczenie techniczne. Pokazują, dlaczego nie wystarczy oceniać modeli wyłącznie na podstawie atrakcyjnych miniaturek.
Ładny obraz i poprawnie wykonane polecenie to dwie różne rzeczy.
A potem okazało się, że pięć zdań po polsku wystarczy.
Przez długi czas testowałem rozbudowane prompty po angielsku. Szczegółowe instrukcje fotograficzne, określenia oświetlenia, kompozycji, anatomii, parametrów obiektywu i sposobu renderowania materiałów.
W końcu postanowiłem zrobić coś zupełnie innego.
Wpisałem:
Kamping nad jeziorem. Samochód z przyczepą mieszkalną zaparkowany pod drzewem. Lekki deszcz. Zmoknięty leżak z przewieszonym ręcznikiem. Brak ludzi.
Pięć prostych zdań. Po polsku.
Bez specjalnych konstrukcji, bez rozbudowanych instrukcji i bez angielskiego słownictwa technicznego.
Otrzymałem zaskakująco wiarygodną fotografię. Zwyczajną, niemal reporterską. Taką, która równie dobrze mogłaby pochodzić z telefonu podczas deszczowego poranka na kempingu.
To był jeden z ważniejszych momentów całego projektu.
Zrozumiałem, że nie muszę budować interfejsu, który zmusza Dorę do poznawania skomplikowanego języka promptowania.
Może po prostu opisywać swoje pomysły własnymi słowami.
Nie oznacza to, że polski zawsze daje lepsze rezultaty niż angielski. Bardziej złożone sceny potrafią zachowywać się różnie w zależności od języka, modelu i konstrukcji polecenia. Ale przekonałem się, że polski może być pełnoprawnym językiem pracy z naszym systemem.
Komputer, który wreszcie dostał coś do roboty.
Cały system działa lokalnie, na mojej stacji roboczej.
Jej sercem jest karta NVIDIA GeForce RTX 5080 z 16 GB pamięci VRAM. Do tego 128 GB pamięci RAM i procesor Intel Core Ultra 7 265KF.
Komputer nie był kupowany z myślą o graniu. Od początku interesowała mnie przede wszystkim wydajność w pracy, projektowaniu, przetwarzaniu danych i eksperymentach z nowymi technologiami.
Mimo to dopiero podczas testów generatywnej sztucznej inteligencji zobaczyłem, jak wygląda jego naprawdę intensywna praca.
Obciążenie GPU dochodzące do 97–99%, pobór mocy około 330–340 W i temperatura karty w granicach 65–68°C.
I moje małe odkrycie: wentylatory na karcie graficznej jednak potrafią się kręcić.
Co ważne, nie potrzebuję chmury obliczeniowej do wykonywania tych operacji. Modele są uruchamiane na moim komputerze, a obrazy powstają lokalnie.
To daje dużą kontrolę nad środowiskiem, konfiguracją, plikami źródłowymi i samym procesem generowania.
Oczywiście nie ma magii. Sprzęt musi pracować, modele zajmują miejsce, a bardziej wymagające operacje potrafią zużyć sporo pamięci i energii. Ale właśnie dlatego chciałem sprawdzić, jak daleko mogę dojść z własną infrastrukturą.
422 GB. Prawie 93 000 plików. A to dopiero początek.
Tu dochodzimy do liczby, która nawet mnie trochę zaskoczyła.
Całe środowisko projektu zajmuje już około 422 GB i zawiera blisko 93 tysiące plików.
Nie, to nie jest rozmiar samej aplikacji DAISY STUDIO.
Na tę wartość składają się przede wszystkim modele sztucznej inteligencji, ich komponenty, biblioteki, środowisko ComfyUI, dodatkowe węzły, zależności i pozostałe elementy lokalnego zaplecza.
Innymi słowy: to ciężar technologii ukrytej pod prostym interfejsem.
I tu pojawia się ciekawy kontrast.
Dora widzi kilka zakładek, pole tekstowe, przycisk generowania i galerię.
Pod spodem pracuje środowisko, które rozrosło się do setek gigabajtów i dziesiątek tysięcy plików.
Tak właśnie rozumiem dobrze zaprojektowane narzędzie: użytkownik nie powinien odczuwać złożoności infrastruktury, która realizuje jego zadanie.
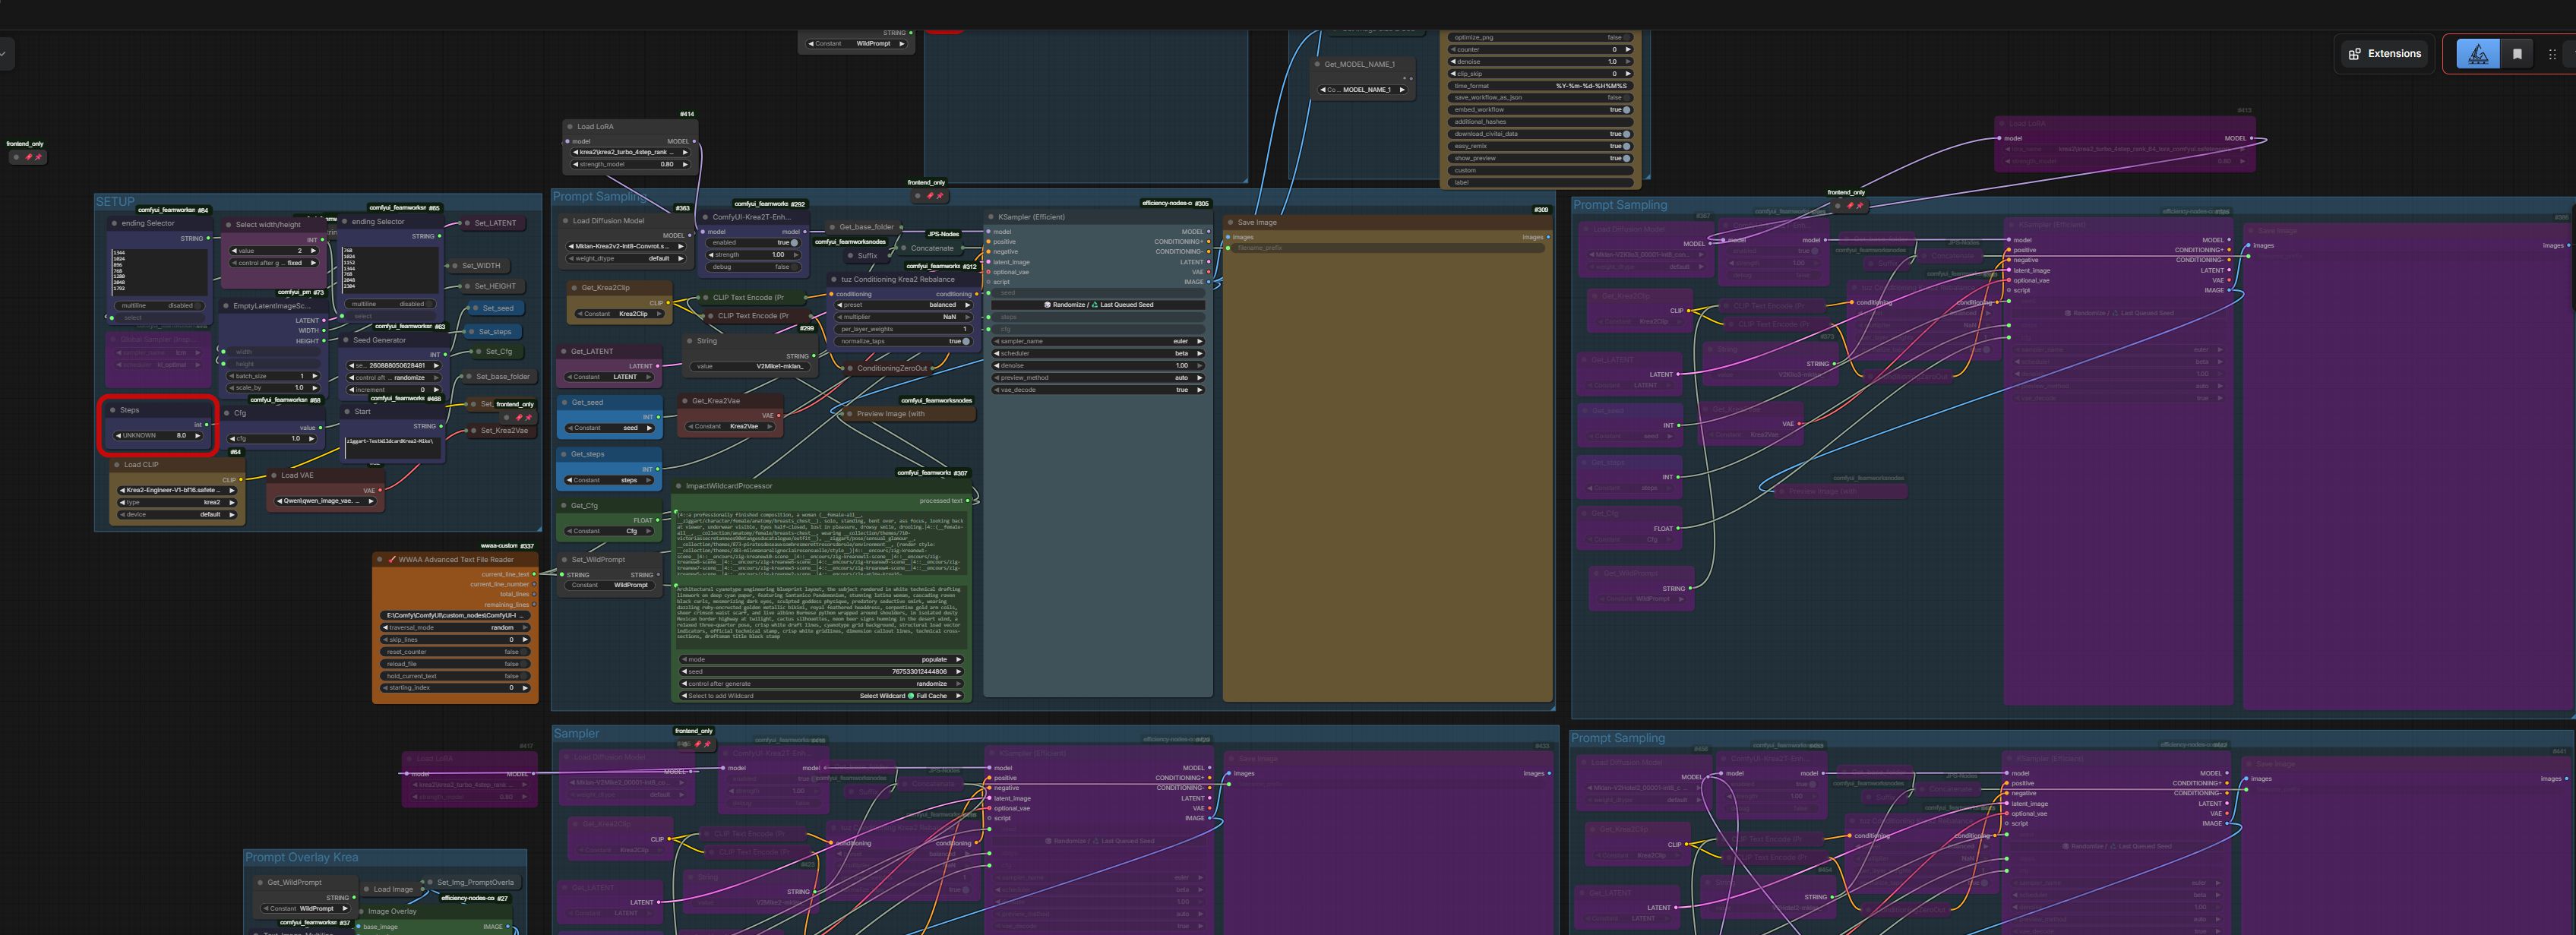
Przełom nastąpił wtedy, kiedy schowałem ComfyUI.
W pewnym momencie uznałem, że dalsze doskonalenie workflowów nie wystarczy.
Mogłem mieć najlepszy zestaw modeli i najbardziej dopracowane ustawienia, ale jeśli każda generacja wymagała otwierania ComfyUI, przesuwania węzłów i ręcznego wybierania parametrów, to nie realizowałem głównego założenia projektu.
Dlatego postanowiłem zbudować osobny interfejs.
Tak narodziło się DAISY STUDIO.
Aplikacja wykorzystuje własny panel oraz serwer Node.js komunikujący się z lokalnym ComfyUI przez API. Użytkownik nie musi oglądać workflowów. Panel przekazuje odpowiednie dane do silnika, uruchamia przetwarzanie i odbiera gotowy obraz.
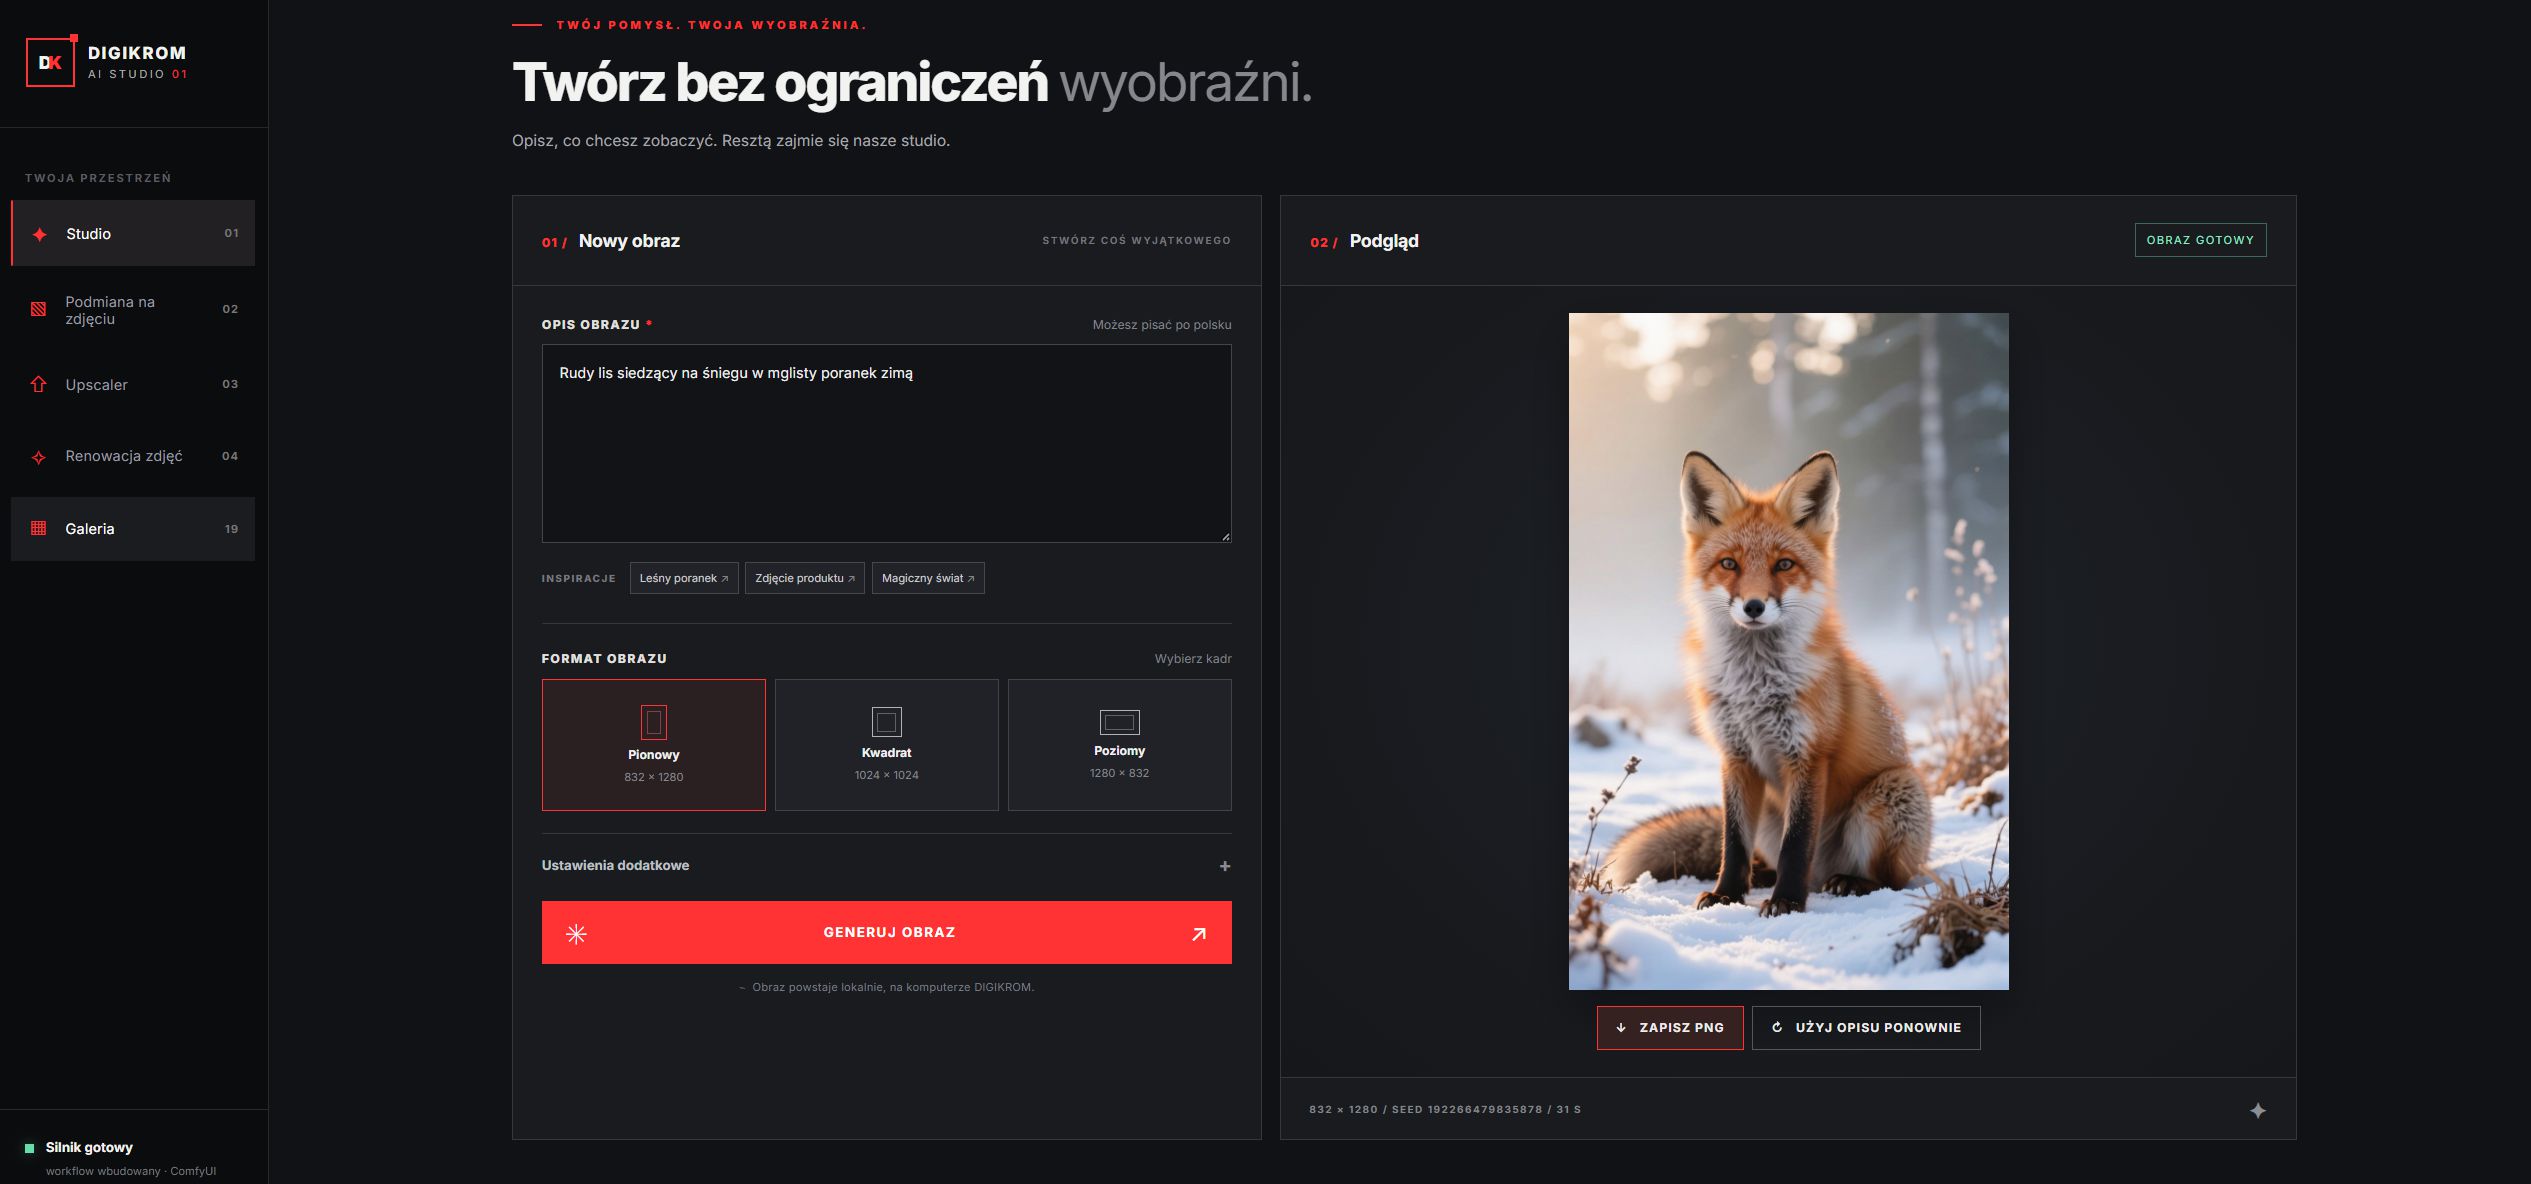
Pierwsza wersja była bardzo prosta: pole promptu, opcjonalny antyprompt, wybór formatu, przycisk generowania, podgląd i galeria.
I wtedy nastąpiło coś, co w projektowaniu oprogramowania lubię najbardziej.
Pierwszy prawdziwy test zakończył się sukcesem.
Wpisałem krótki prompt o rudym lisie siedzącym na śniegu. Po około 30 sekundach otrzymałem gotową fotografię bezpośrednio w panelu.
Żadnego ręcznego uruchamiania węzłów. Żadnego przechodzenia do ComfyUI. Żadnego kopiowania obrazów z katalogu wynikowego.
Po prostu: opisałem obraz, kliknąłem i otrzymałem wynik.
Jedno studio. Dwa komputery. Jedna karta graficzna.
Kolejne wyzwanie wynikało z samej idei projektu.
DAISY STUDIO powstaje dla Dory, ale jej komputer nie musi mieć sprzętu potrzebnego do uruchamiania dużych modeli AI.
I nie ma powodu, żeby miał.
Cała moc obliczeniowa znajduje się na mojej stacji roboczej. Komputer Dory ma służyć tylko do obsługi interfejsu.
Udostępniłem więc panel w domowej sieci lokalnej. Teraz Dora może otworzyć DAISY STUDIO u siebie, a generowanie i przetwarzanie obrazów odbywa się na mojej RTX 5080.
Nie musi instalować ComfyUI, pobierać modeli ani utrzymywać drugiego środowiska AI.
Wystarczy przeglądarka i skrót do aplikacji.
W ten sposób powstała mała, prywatna infrastruktura AI dla dwóch stanowisk pracy.
Bez konieczności wysyłania każdego obrazu do zewnętrznej usługi generowania. Bez oddzielnych instalacji modeli. Bez komplikowania życia osobie, dla której cały projekt powstał.
Jedna funkcja? To byłoby zbyt proste.
Oczywiście na generatorze obrazów się nie skończyło.
Podczas kolejnych eksperymentów znajdowałem workflowy realizujące zupełnie inne zadania. Każdy z nich działał dobrze w ComfyUI, ale pojawiał się ten sam problem: jak udostępnić jego możliwości w prostym panelu?
Odpowiedź okazała się oczywista.
Zamiast budować osobne aplikacje, zacząłem rozbudowywać DAISY STUDIO o kolejne moduły.
01. Studio — generowanie obrazów
Podstawowa funkcja, od której wszystko się zaczęło.
Wpisuję prompt, wybieram proporcje obrazu i uruchamiam generowanie. Silnik oparty na Qwen-Image wykonuje pracę w tle, a gotowy wynik pojawia się w panelu.
Mogę korzystać z rozbudowanych poleceń fotograficznych, ale także z prostych opisów po polsku.
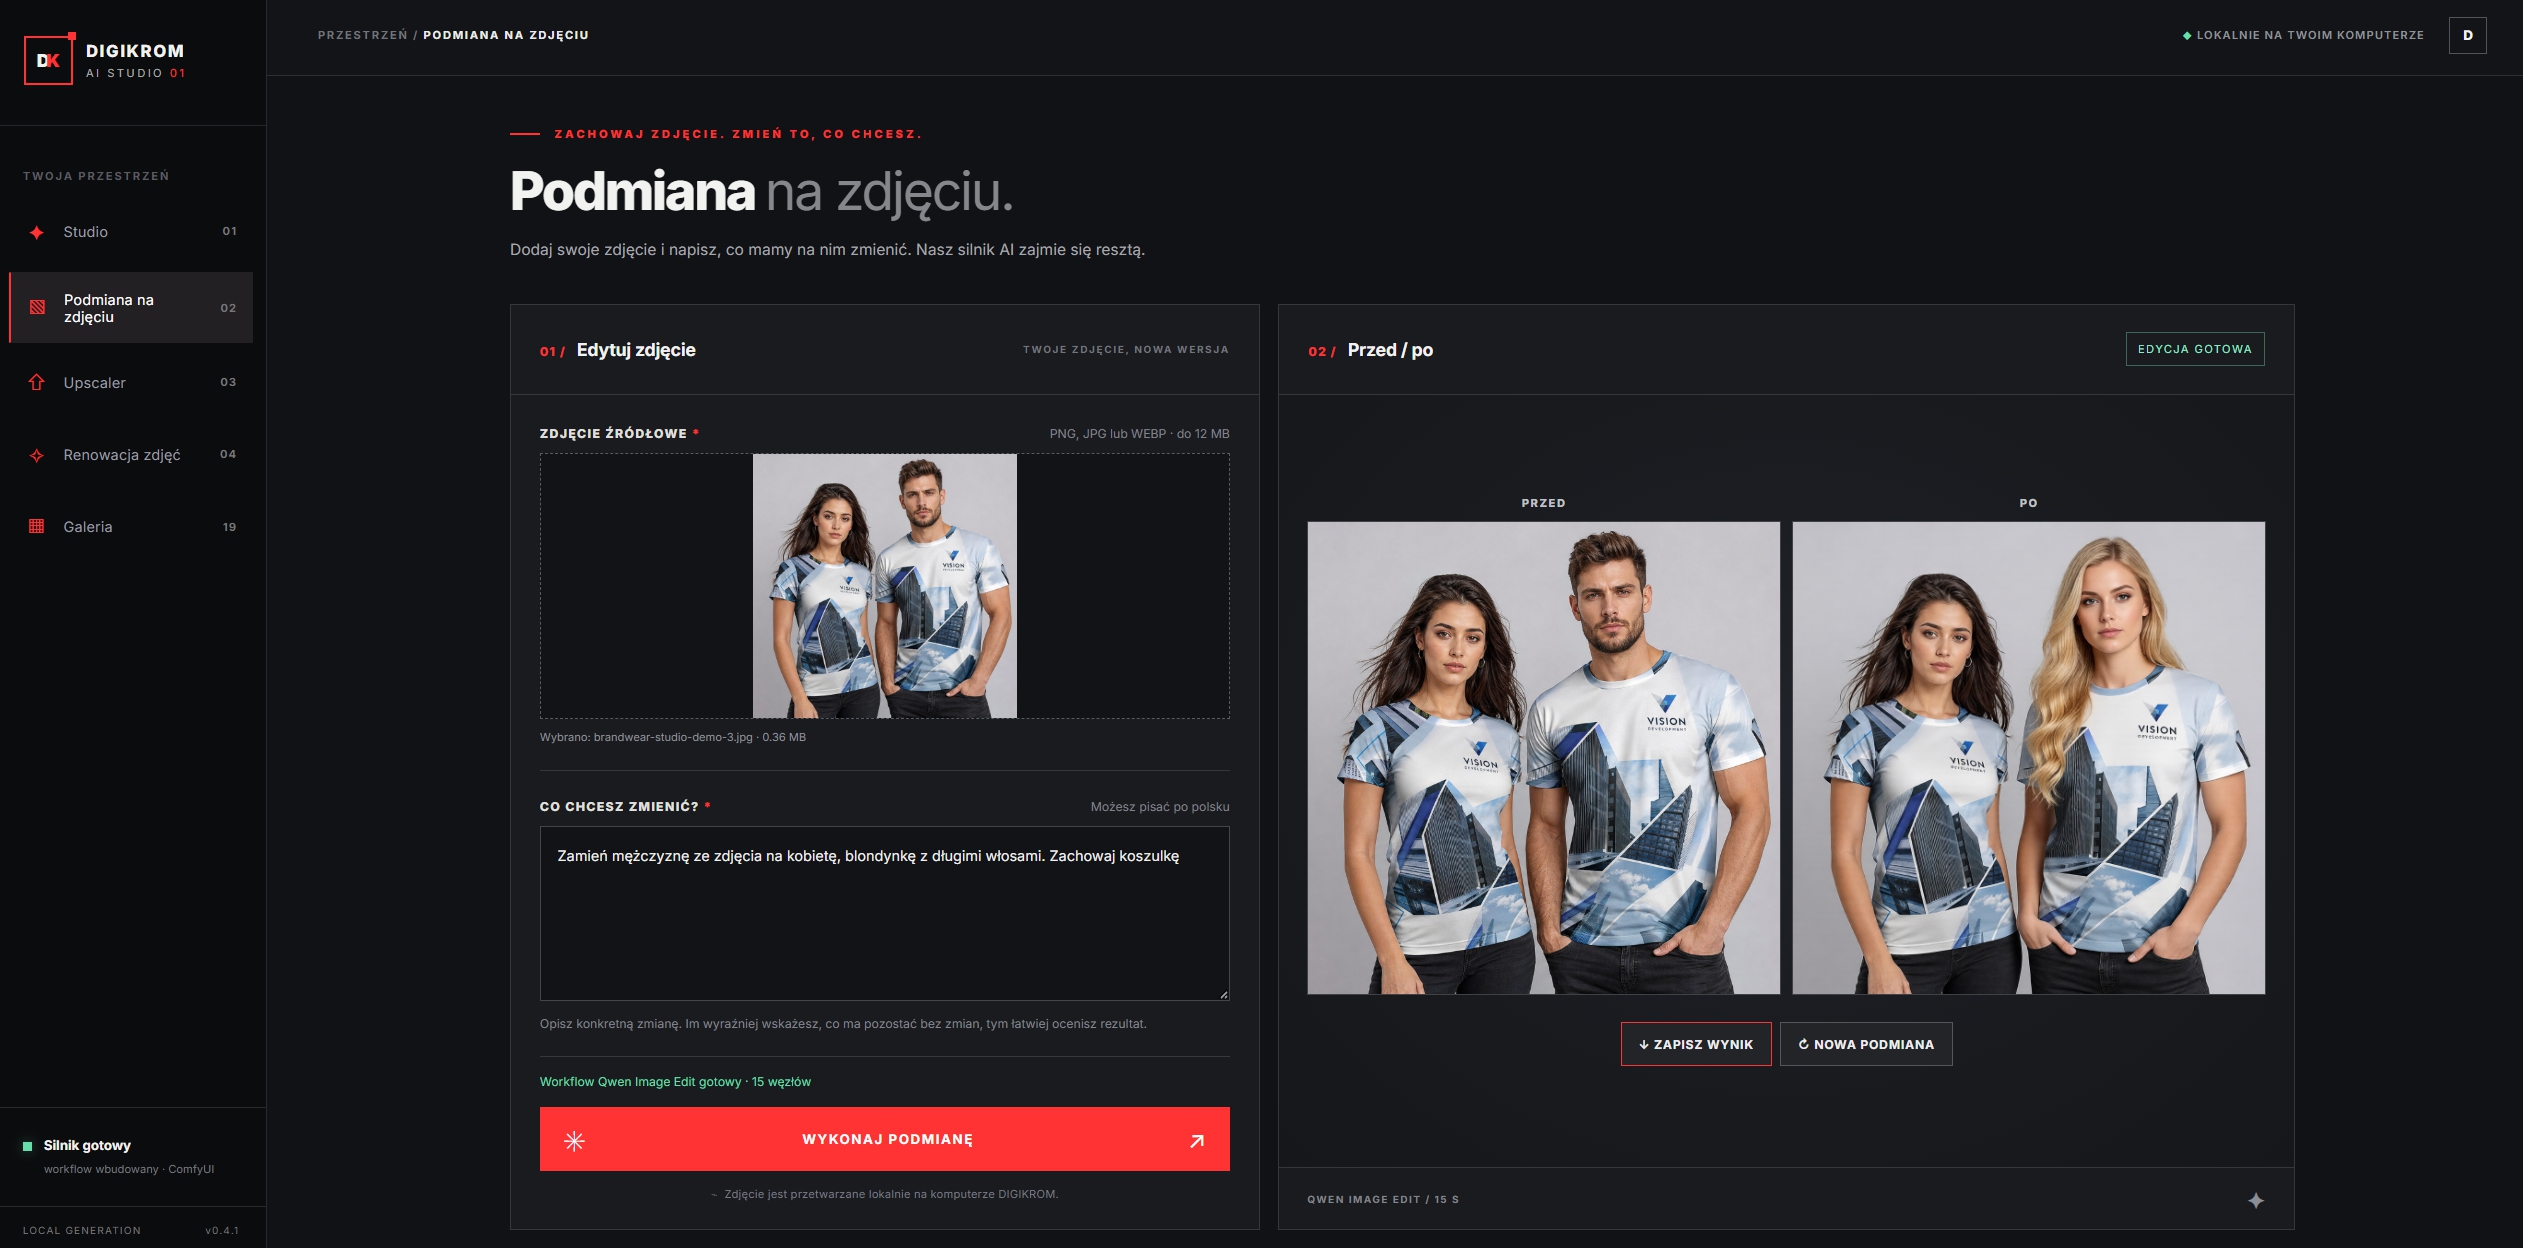
02. Podmiana na zdjęciu — zmieniam to, co chcę
Kolejny moduł wykorzystuje Qwen Image Edit.
Wgrywam istniejące zdjęcie i opisuję, co ma zostać zmienione. Może to być obiekt, kolor, element ubioru, fragment otoczenia albo wybrany szczegół kompozycji.
W jednym z testów zmieniłem kolor rozpryśniętego lakieru wokół produktu kosmetycznego. Model zachował układ zdjęcia, opakowanie i jego oznaczenia, modyfikując wskazany element.
To szczególnie interesujący kierunek dla fotografii produktowej, gdzie często trzeba zmienić konkretną rzecz bez przebudowy całego kadru.
03. Upscaler — więcej szczegółów, ten sam obraz
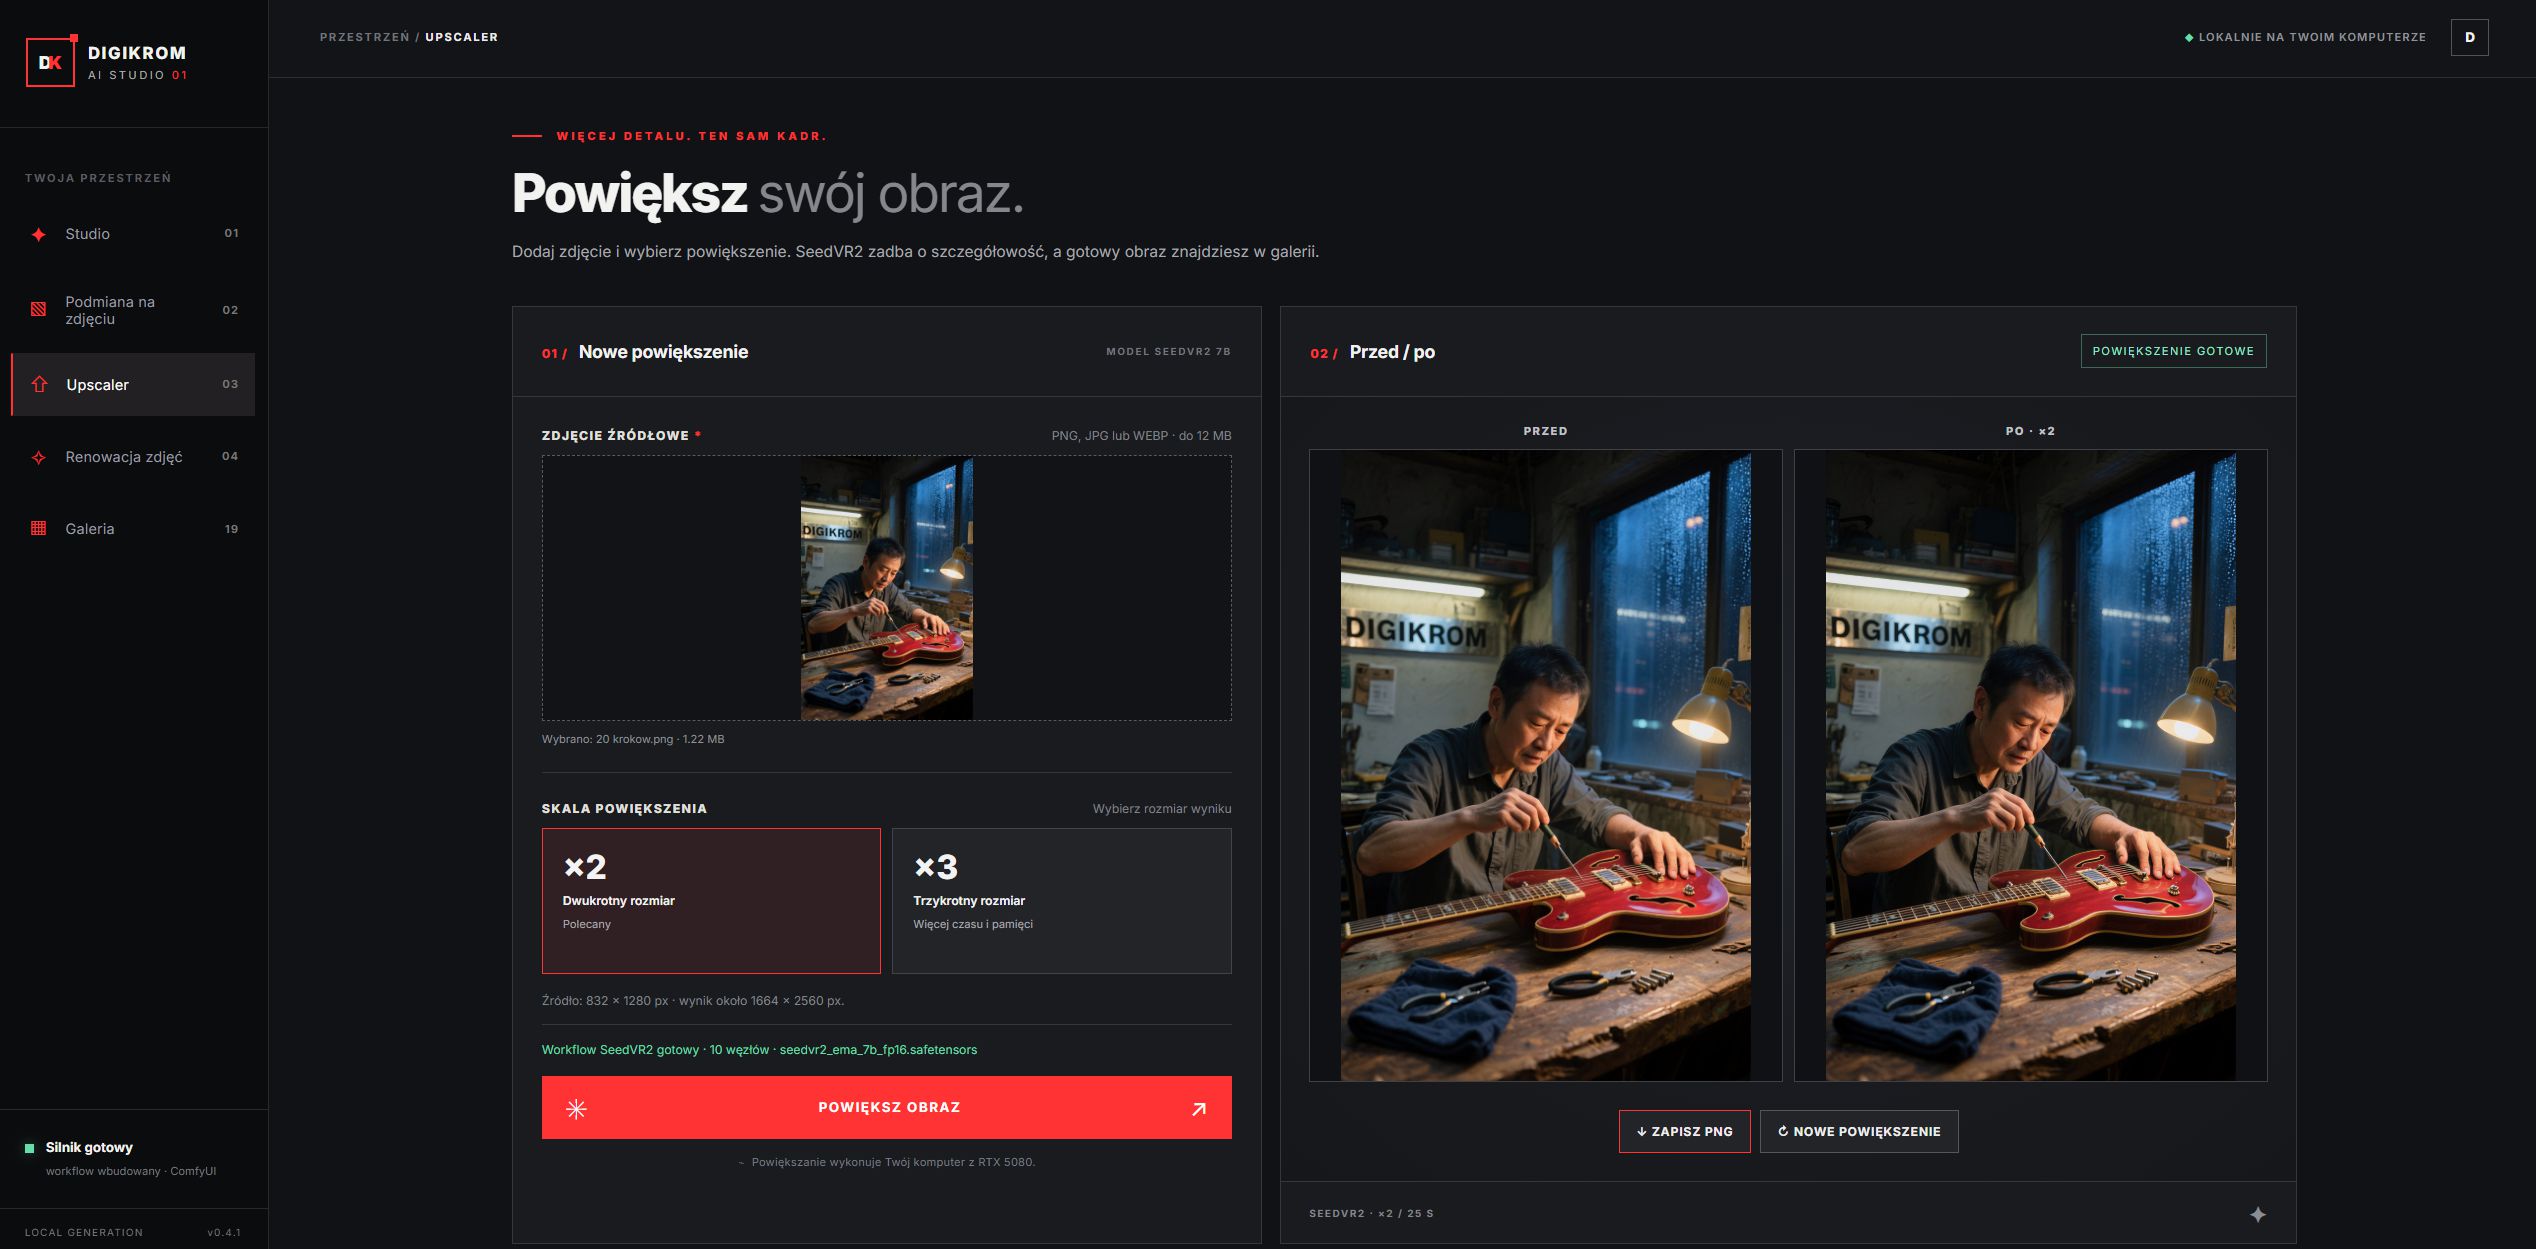
Ten moduł był jednym z najbardziej wyczekiwanych.
Podczas wcześniejszych testów zauważyłem, że generowanie od razu w ogromnej rozdzielczości nie zawsze daje lepsze rezultaty.
Przykładowo przy zdjęciu zegarka powiększenie płótna do 2000 × 4000 pikseli sprawiło, że model zaczął generować dwa zegarki zamiast jednego.
Wróciłem więc do znacznie rozsądniejszej zasady: najpierw poprawna kompozycja, później zwiększanie rozdzielczości.
W DAISY STUDIO odpowiada za to SeedVR2. Mogę wybrać dwukrotne lub trzykrotne powiększenie i otrzymać obraz o większych wymiarach bez ponownego tworzenia całej sceny.
Co ważne, zależy mi nie tylko na większej liczbie pikseli. Sprawdzam, czy pozostają zachowane twarz, fryzura, detale ubioru, biżuteria, proporcje i kompozycja.
W moich porównaniach ten workflow potrafił zachowywać wygląd oryginału lepiej niż część popularnych narzędzi AI, które wcześniej testowałem. Nie traktuję tego jako uniwersalnego rankingu. Upscaling generatywny nadal może dopowiadać szczegóły, ale uzyskane rezultaty są dla mnie bardzo obiecujące.
04. Renowacja fotografii — przywracanie wspomnień
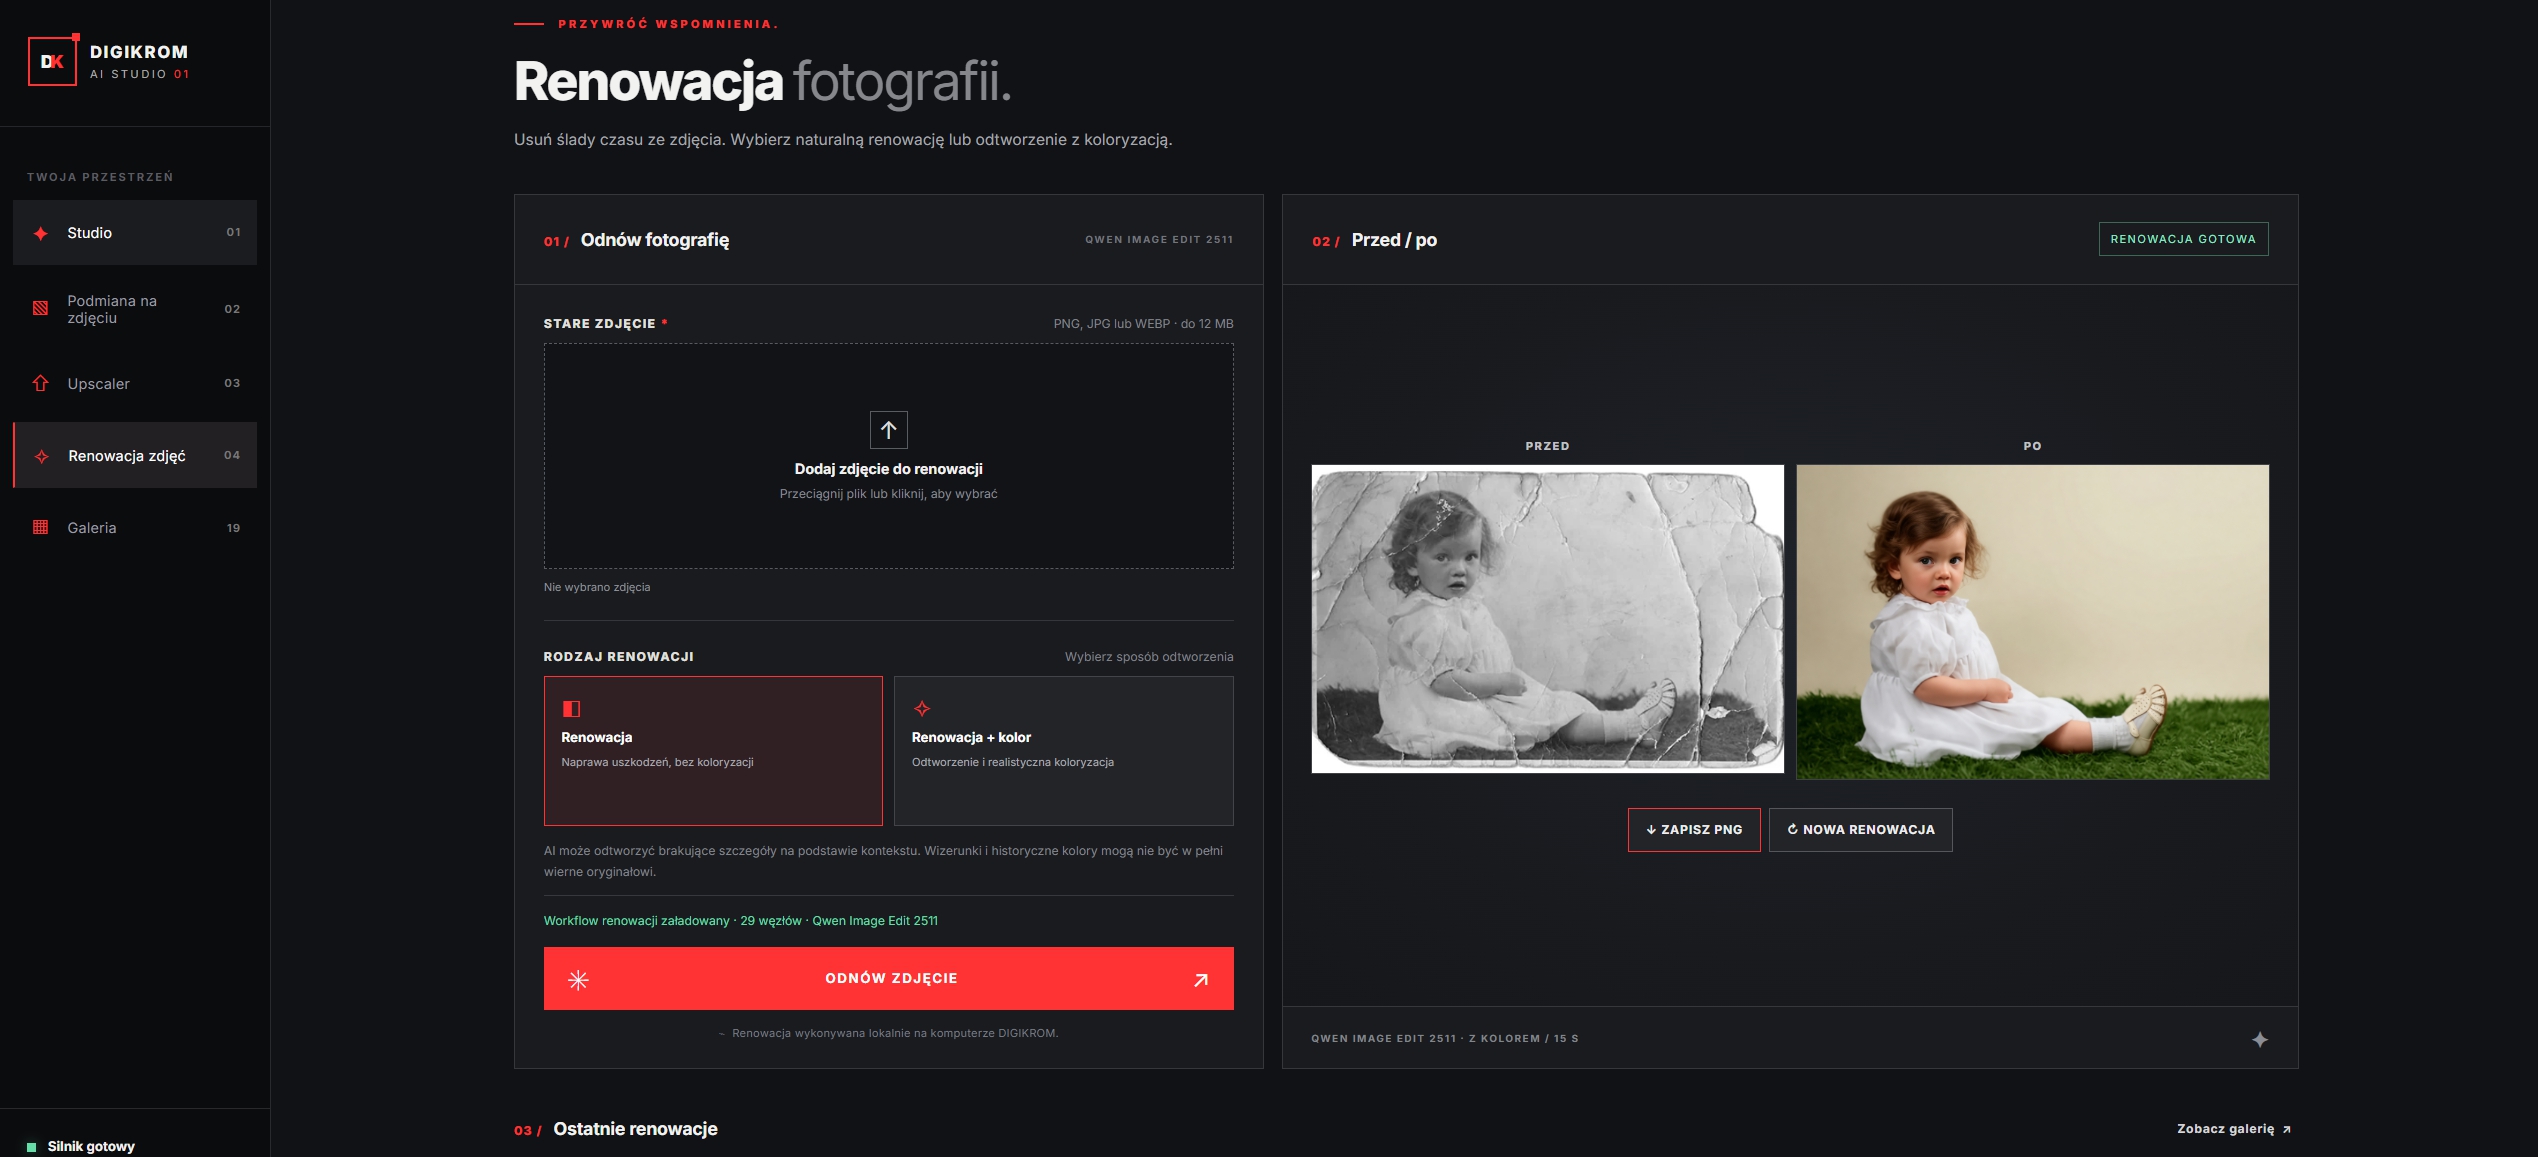
Najnowszy moduł wykorzystuje Qwen Image Edit 2511 i służy do pracy ze starymi, zniszczonymi zdjęciami.
Przygotowałem dwa tryby: zwykłą renowację oraz renowację połączoną z koloryzacją.
System może usuwać rysy, zagięcia, plamy i ślady uszkodzeń, poprawiać czytelność fotografii oraz próbować rekonstruować utracone fragmenty obrazu.
Niektóre wyniki są naprawdę zaskakujące. Stare, mocno zniszczone fotografie odzyskują czytelność, a postacie i przedmioty stają się ponownie wyraźne.
Ale tutaj stawiam ważne zastrzeżenie.
Renowacja generatywna nie jest odzyskiwaniem prawdy historycznej.
Jeśli oryginalna fotografia nie zawiera już informacji o kształcie twarzy, fakturze ubrania czy kolorze materiału, model może stworzyć wiarygodne wizualnie uzupełnienie. Nie oznacza to, że odtworzył rzeczywisty wygląd fotografowanej osoby.
Dlatego w DAISY STUDIO zachowuję możliwość porównania oryginału z wynikiem. Przy szczególnie zniszczonych zdjęciach taki rezultat traktuję jako interpretację i rekonstrukcję, a nie dokumentalny dowód.
60 sekund. Od pomysłu do powiększonego obrazu.
W którymś momencie postanowiłem przetestować kompletny proces.
Nie pojedynczy model. Nie sam upscaler. Całą drogę, którą będzie przechodzić użytkownik.
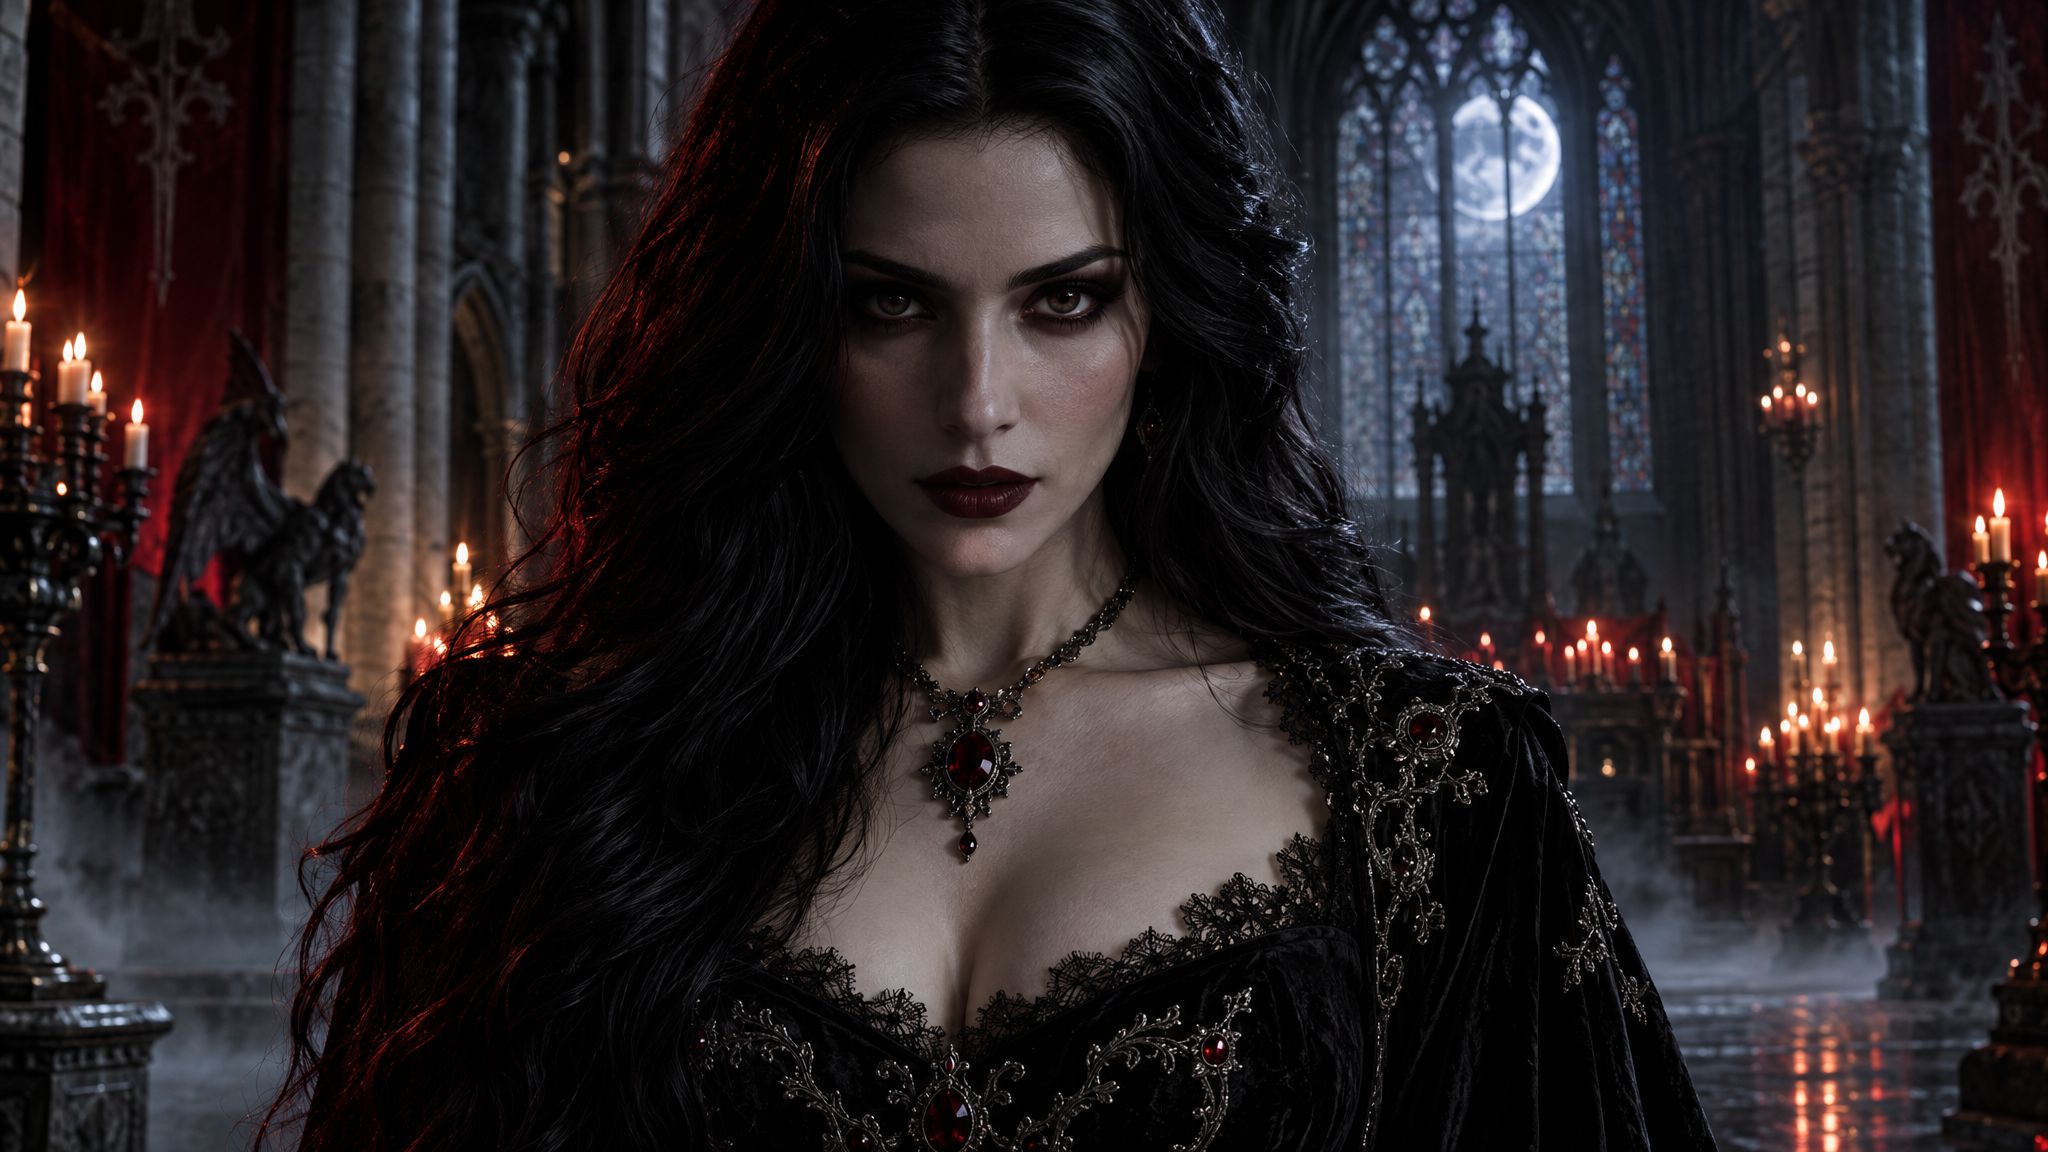
Przygotowałem prompt przedstawiający kobietę w czarnej, bogato zdobionej sukni, stojącą we wnętrzu gotyckiej katedry.
Uruchomiłem generowanie w DAISY STUDIO.
Po otrzymaniu obrazu przeszedłem do zakładki Upscaler i wykonałem dwukrotne powiększenie.
Łączny czas: około 60 sekund.
Od pomysłu opisanego tekstem do gotowej fotografii o dwukrotnie większej szerokości i wysokości.
Bez wychodzenia z aplikacji.
Wynik zachował charakter twarzy, fryzurę, elementy stroju i kompozycję. Dodatkowe szczegóły najlepiej oceniać w powiększeniu, ale już sam kompletny proces pokazał mi, jak użyteczne staje się to narzędzie.
W innych testach uzyskiwałem około 13–15 sekund dla renowacji, kilkanaście sekund dla wybranych operacji edycyjnych i około 30 sekund dla typowego generowania fotografii.
To oczywiście czasy konkretnych testów, a nie gwarantowane parametry. Zależą od modelu, rozdzielczości, dostępnej pamięci i rodzaju operacji.
A skoro mowa o upscalingu… zrobiłem też coś zupełnie nierozsądnego.
Jednym z najbardziej pamiętnych eksperymentów był test powiększania obrazu, który już na starcie miał wysoką rozdzielczość i mnóstwo szczegółów.
Źródłowa grafika miała 2048 × 1152 pikseli. Nie był to niewyraźny szkic, tylko złożony obraz z dużą liczbą detali, kolorów i drobnych elementów.
Postanowiłem mimo wszystko przepuścić go przez upscaler.
Przy powiększeniu ×2 jeden z testów zakończył się po około 22 sekundach.
Potem przyszła kolej na ×3.
344 sekundy.
Prawie sześć minut pracy.
Ten eksperyment bardzo wyraźnie pokazał, że czas przetwarzania nie rośnie liniowo wraz z wybranym mnożnikiem. Znaczenie mają także liczba pikseli, architektura modelu, sposób zarządzania pamięcią i charakter samego obrazu.
Dlatego w panelu pozostawiłem użytkownikowi prosty wybór, ale pod spodem cały czas testuję wydajność i jakość.
Bo właśnie o to chodzi w DAISY STUDIO: prostota obsługi nie zwalnia mnie z rozumienia, co dzieje się po drugiej stronie przycisku.
Bez kagańca. Ale również bez rezygnacji z odpowiedzialności.
Jest jeszcze jeden aspekt, który warto poruszyć otwarcie.
Jednym z powodów zainteresowania lokalnymi modelami AI była możliwość znacznie większej kontroli nad tym, co i w jaki sposób mogę generować.
W popularnych usługach internetowych użytkownik podlega zasadom i ograniczeniom określonym przez dostawcę. Nie zawsze wynikają one wyłącznie z bezpieczeństwa. Czasem wpływają również na sposób przedstawiania postaci, tematów artystycznych czy estetyki obrazu.
W przypadku lokalnego środowiska mam możliwość wyboru modelu, adapterów LoRA, parametrów i sposobu działania całego procesu. Nie korzystam z obowiązkowej, zewnętrznej warstwy moderacji typowej dla części usług chmurowych.
Nie oznacza to jednak, że projekt powstał jako zabawka do generowania pornografii albo obchodzenia odpowiedzialności za publikowane treści.
Chodzi o swobodę twórczą i kontrolę nad narzędziem.
O możliwość pracy nad ambitniejszymi koncepcjami artystycznymi, realistyczną anatomią, fotografią stylizowaną, tematami historycznymi i scenami, których charakter może być bardziej wymagający niż standardowa fotografia reklamowa.
Taka swoboda wymaga jednocześnie rozsądku. Lokalny model nie zwalnia z poszanowania prywatności, praw autorskich, wizerunku innych osób ani obowiązującego prawa.
Dla mnie to nie sprzeczność.
To po prostu odpowiedzialne korzystanie z narzędzia, nad którym mam większą kontrolę.
Jednoosobowa firma i AI jako partner w tworzeniu oprogramowania.
W tym miejscu warto powiedzieć coś jeszcze.
DIGIKROM jest jednoosobową firmą.
Nie stoi za tym projektem osobny dział programistyczny, grupa specjalistów od machine learningu i zespół projektantów interfejsów.
Dużą rolę w jego powstaniu odegrała moja współpraca z Ai
AI pomagało mi analizować błędy, rozumieć konfiguracje modeli, projektować architekturę aplikacji i tworzyć kolejne wersje oprogramowania. Ja przygotowywałem środowisko, kod, wybierałem modele, wykonywałem testy, oceniałem rezultaty, podejmowałem decyzje i wdrażałem rozwiązania na własnym sprzęcie.
Ta współpraca nie polegała na wpisaniu jednego polecenia „zbuduj mi studio AI” i otrzymaniu gotowego produktu.
Były dziesiątki prób, błędy, poprawki, porównania obrazów, nietrafione założenia i kolejne iteracje.
Bywało też zabawnie, szczególnie kiedy model językowy oceniał atrakcyjność wygenerowanej fotografii, nie zauważając, że przedstawiona postać ma dodatkową rękę.
To przypominało mi o czymś fundamentalnym.
AI może znakomicie przyspieszać pracę, ale nadal potrzebuje człowieka, który potrafi ocenić wynik i zakwestionować błędną odpowiedź.
DAISY STUDIO jest dla mnie również przykładem tego, jak znacząco zmienia się sposób tworzenia oprogramowania w małej firmie.
Nie dlatego, że technologia nagle stała się bezbłędna.
Dlatego, że przy odpowiednim podejściu pozwala realizować pomysły, których skala jeszcze niedawno wymagałaby zupełnie innych zasobów.
Dlaczego publikuję Case Study projektu, który nie jest gotowy?
To chyba najdziwniejszy element całej historii.
DAISY STUDIO wciąż rozwijam.
Obecna wersja 0.4.1 obejmuje cztery główne moduły, galerię, podgląd wyników, historię prac, możliwość usuwania nieudanych zdjęć i dostęp z drugiego komputera.
To już działające, praktyczne oprogramowanie.
Ale czy jest ukończone?
Nie. I zaczynam podejrzewać, że nigdy nie będzie.
Rozwój generatywnej sztucznej inteligencji jest obecnie tak szybki, że trudno zaplanować zamkniętą listę funkcji na kilka lat do przodu.
Nowe modele, nowe architektury, nowe sposoby edycji obrazów, coraz lepsze metody powiększania i rekonstrukcji szczegółów. Rozwiązania, które jeszcze niedawno wydawały się eksperymentalne, zaczynają trafiać do codziennej pracy.
Nie wiem, jaki model przetestuję jutro.
Nie wiem, czy za miesiąc pojawi się technologia, która całkowicie zmieni sposób działania któregoś z obecnych modułów.
Nie wiem nawet, ile nowych zakładek będzie miało DAISY STUDIO za pół roku.
I właśnie dlatego zdecydowałem się opublikować tę historię już teraz.
Nie jako prezentację zakończonego wdrożenia.
Jako dokumentację momentu, w którym eksperyment zamienił się w użyteczny produkt, a produkt zaczął ewoluować w platformę.
Największy sukces tego projektu nie ma nic wspólnego z liczbą parametrów modelu.
Mógłbym zakończyć ten wpis tabelą technologii, wyników i parametrów sprzętowych.
Mógłbym napisać o 422 GB środowiska, niemal 93 tysiącach plików, wydajności RTX 5080 czy tym, że cały proces tworzenia i powiększania fotografii zamyka się czasem w jednej minucie.
Wszystkie te liczby są ciekawe.
Ale nie one są dla mnie najważniejsze.
Najważniejsze jest to, że mogę usiąść przy swoim komputerze, rozwijać skomplikowane narzędzie oparte na lokalnych modelach AI, a Dora może z niego korzystać na swoim stanowisku, nie interesując się całą techniczną stroną przedsięwzięcia.
Może wpisać pomysł po polsku, wygenerować obraz, poprawić fotografię, powiększyć ją albo odnowić stare zdjęcie.
Może po prostu tworzyć.
Dokładnie tak, jak zakładałem od początku.
Projekt nazywa się DAISY STUDIO, ponieważ powstaje właśnie dla niej.
I chociaż po drodze pojawiły się dziesiątki nowych pomysłów, niezliczone testy oraz setki gigabajtów technologicznego zaplecza, ten jeden cel pozostał niezmienny.
Nie chciałem nauczyć Dory obsługi sztucznej inteligencji. Ona to potrafi i jest już w tym świetna.
Chciałem zbudować sztuczną inteligencję, którą Dora będzie mogła po prostu obsługiwać.
I wygląda na to, że dopiero się rozkręcam.
DAISY STUDIO / DIGIKROM AI STUDIO
Wersja opisana w artykule: 0.4.1. Projekt w aktywnym rozwoju.
2026-10-25Czerwony alert DIGIKROM Hub. Jak wykryliśmy i opanowaliśmy przeciążenie sklepu↗
2026-09-29Od jednego screena bolidu do własnego cyfrowego muzeum. Jak zbudowałem RACECRAFT↗
2026-09-19Od ręcznej kontroli do własnego centrum operacyjnego. Jak zbudowałem DIGIKROM Hub dla ponad 50 stron↗
2026-09-02Szalona Italia — od technicznego długu do własnego ekosystemu e-commerce↗
2026-08-22Jak przeniosłem DIGIKROM z WordPressa na własny Static Hybrid bez zmiany adresów URL — Case Study↗