
Co to jest server-side tracking i czym różni się od śledzenia w przeglądarce?
Najważniejsze w skrócie
Server-side tracking pozwala przetwarzać i przekazywać zdarzenia analityczne przez kontrolowany serwer, zamiast opierać cały pomiar na skryptach działających w przeglądarce. Może poprawić jakość danych, wydajność i kontrolę nad integracjami, ale wymaga przemyślanej architektury, deduplikacji zdarzeń i prawidłowej obsługi zgód użytkowników.
W tym haśle
Server-side tracking to sposób zbierania, przetwarzania i przekazywania danych analitycznych z wykorzystaniem warstwy serwerowej. Zamiast wysyłać wszystkie informacje bezpośrednio z przeglądarki użytkownika do Google Analytics, Google Ads czy innych platform reklamowych, część komunikacji odbywa się przez serwer kontrolowany przez właściciela strony lub dostawcę obsługującego jego infrastrukturę. Dzięki temu można lepiej zarządzać przesyłanymi informacjami, kontrolować integracje i w określonych sytuacjach poprawić jakość pomiaru.
Server-side tracking nie jest jednak magicznym rozwiązaniem wszystkich problemów analityki. Nie sprawia, że każdy zakup zostanie poprawnie przypisany reklamie, nie eliminuje wszystkich ograniczeń przeglądarek i nie pozwala ignorować decyzji użytkowników dotyczących prywatności. To przede wszystkim inna architektura pomiaru. Jej skuteczność zależy od jakości wdrożenia, źródeł danych, identyfikatorów zdarzeń, obsługi zgód i sposobu łączenia informacji z rzeczywistą sprzedażą.
Co to jest server-side tracking?
Server-side tracking oznacza wykorzystanie serwera do obsługi określonych etapów pomiaru aktywności użytkowników lub zdarzeń biznesowych. W tradycyjnym podejściu przeglądarka uruchamia skrypty analityczne i reklamowe. Każdy z nich może wysyłać informacje do właściwej platformy. W podejściu serwerowym dane mogą najpierw trafiać do kontrolowanego punktu przetwarzania. Dopiero tam system decyduje:- które zdarzenia przyjąć,
- jakie informacje są potrzebne,
- czy dane spełniają określone warunki,
- co należy usunąć lub zmodyfikować,
- do których systemów przekazać zdarzenie.
Client-side tracking a server-side tracking
Client-side tracking oznacza pomiar wykonywany przede wszystkim w środowisku użytkownika, najczęściej w przeglądarce internetowej. Po wejściu na stronę uruchamiają się odpowiednie skrypty. Mogą reagować na zdarzenia, odczytywać dozwolone identyfikatory i przesyłać informacje do systemów analitycznych. Przykładowo przeglądarka może zgłosić:- wyświetlenie produktu,
- kliknięcie przycisku,
- dodanie do koszyka,
- rozpoczęcie checkoutu,
- wysłanie formularza.
Dlaczego tradycyjny pomiar może tracić dane?
Pomiar w przeglądarce zależy od wielu elementów, nad którymi właściciel strony nie posiada pełnej kontroli. Znaczenie mogą mieć:- ustawienia prywatności,
- ograniczenia przeglądarki,
- blokowanie skryptów,
- brak wymaganej zgody,
- problemy z połączeniem,
- błędy JavaScript,
- przerwanie ładowania strony.
Czy server-side tracking odzyskuje wszystkie utracone konwersje?
Nie. To jedna z najczęściej powtarzanych, a jednocześnie najbardziej mylących obietnic. Server-side tracking może ograniczać określone problemy techniczne związane z przesyłaniem zdarzeń. Nie potrafi jednak automatycznie odtworzyć informacji, które nigdy nie zostały prawidłowo zebrane. Jeżeli nie znamy źródła wizyty, same dane o zakupie nie powiedzą nam, która reklama go wygenerowała. Jeżeli użytkownik nie wyraził wymaganej zgody na określone przetwarzanie, przesłanie danych inną drogą nie zmienia tej decyzji. Jeżeli identyfikatory są nieprawidłowe, serwer nie naprawi ich wyłącznie przez zmianę adresu docelowego żądania. Dlatego prawidłowe pytanie nie brzmi: „Ile procent konwersji odzyskamy?”. Znacznie lepsze jest: „Które konkretnie błędy obecnego pomiaru możemy usunąć dzięki zmianie architektury?”.Jak działa server-side tracking krok po kroku?
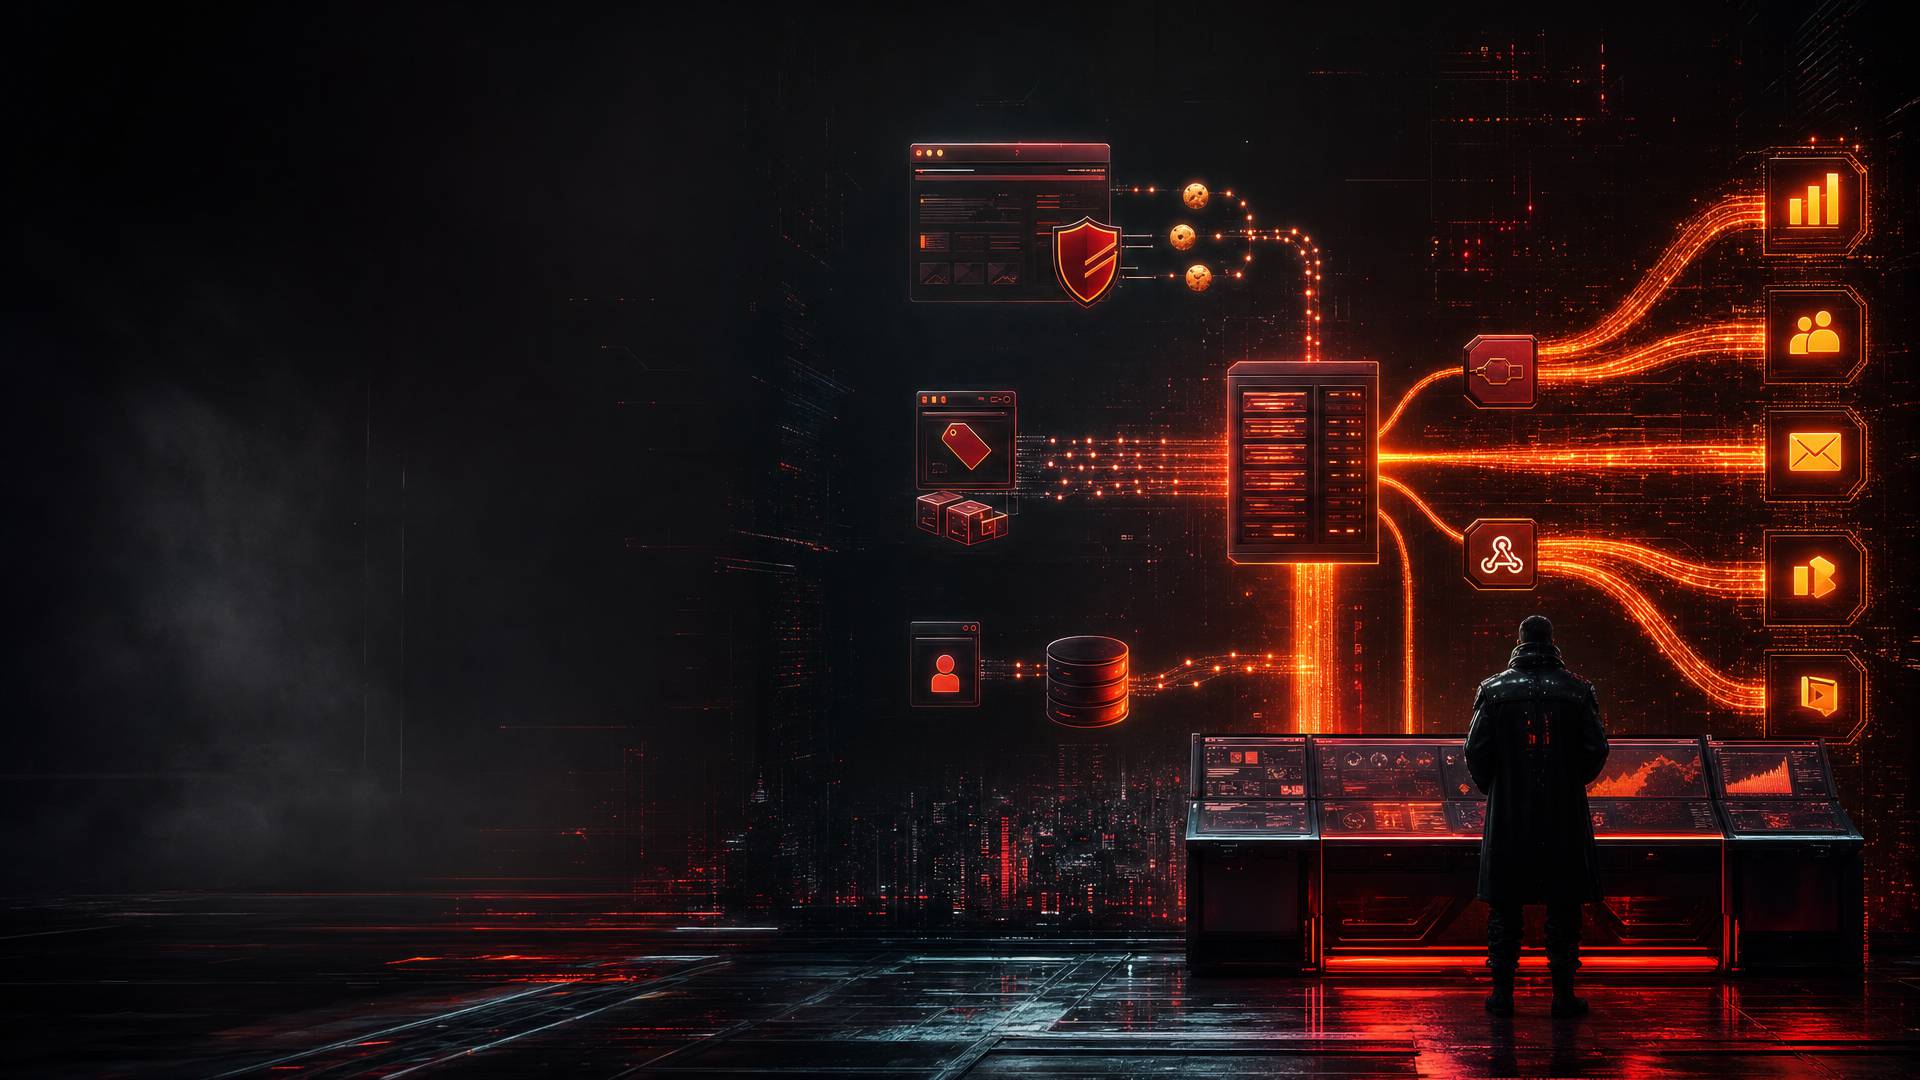
W typowym wdrożeniu proces może wyglądać następująco:- Użytkownik wykonuje działanie na stronie.
- System wykrywa odpowiednie zdarzenie.
- Dane trafiają do kontrolowanego endpointu pomiarowego.
- Serwer identyfikuje rodzaj zdarzenia.
- Sprawdza konfigurację, uprawnienia i odpowiednie sygnały zgody.
- Przetwarza oraz normalizuje informacje.
- Przekazuje dozwolone dane do wybranych systemów.
- Zapisuje wynik techniczny operacji, jeśli przewiduje to architektura.
Co to jest Google Tag Manager Server-Side?
Google Tag Manager posiada możliwość tworzenia kontenerów serwerowych. W tradycyjnym GTM kontener webowy działa w przeglądarce. Pozwala zarządzać tagami, regułami i zmiennymi. W GTM Server-Side kontener działa w środowisku serwerowym. Odbiera żądania pomiarowe, interpretuje je i wykonuje odpowiednio skonfigurowane tagi serwerowe. To rozwiązanie często określa się jako sGTM. Można je uruchomić na infrastrukturze Google Cloud albo przygotować wdrożenie w innym obsługiwanym środowisku. Najważniejsze jest to, że GTM Server nie jest osobnym systemem analitycznym. Nie zastępuje Google Analytics. Jest warstwą obsługującą przesyłanie i przetwarzanie zdarzeń.Czym różni się kontener webowy od serwerowego?
Kontener webowy działa w przeglądarce użytkownika. Ma dostęp do określonych zdarzeń strony, danych udostępnionych przez aplikację i informacji dostępnych w środowisku przeglądarki. Kontener serwerowy działa poza urządzeniem użytkownika. Otrzymuje odpowiednio przygotowane żądania. Może przetwarzać je i przekazywać do innych usług. Oba kontenery często współpracują. Przykład: Kontener webowy wykrywa zdarzenie dodania do koszyka. Dane trafiają do serwerowego kontenera GTM. Kontener serwerowy przygotowuje zdarzenie dla odpowiedniej platformy analitycznej. Nie należy jednak zakładać, że uruchomienie kontenera serwerowego automatycznie usuwa potrzebę prawidłowego wdrożenia po stronie przeglądarki.Do czego służy klient w GTM Server-Side?
W serwerowym Google Tag Managerze klient jest komponentem odpowiedzialnym za rozpoznawanie i interpretowanie przychodzących żądań. To inne pojęcie niż klient sklepu internetowego. Przykładowo klient GA4 może rozpoznawać żądania wysyłane w odpowiednim formacie i przekształcać je na dane zdarzeń dostępne dla kontenera. Następnie tagi serwerowe mogą wykorzystać te informacje. Architektura obejmuje więc:- źródło żądania,
- komponent przyjmujący i interpretujący dane,
- reguły oraz zmienne,
- tagi odpowiedzialne za dalszą wysyłkę.
Server-side tracking a własna domena
Część wdrożeń korzysta z własnej subdomeny jako adresu serwera pomiarowego. Przykładowo:metrics.przykladowa-firma.pl
Może ona prowadzić do infrastruktury obsługującej pomiar.
Zaletą jest możliwość organizowania komunikacji w kontekście własnej domeny.
W odpowiednich konfiguracjach może to również wspierać mechanizmy cookies first-party oraz ograniczać zależność od bezpośrednich połączeń przeglądarki z wieloma dostawcami.
Ale trzeba rozróżnić kilka rzeczy.
Własna subdomena nie oznacza automatycznie, że cały proces jest prywatny.
Nie oznacza również, że żadne informacje nie trafiają do zewnętrznych firm.
Jeżeli serwer pomiarowy przekazuje dane do Google lub Meta, nadal są one przekazywane tym odbiorcom.
Adres pod własną domeną nie zmienia tego faktu.
Czy własna subdomena pozwala ominąć adblocki?
Nie należy tego obiecywać. Niektóre mechanizmy blokowania mogą reagować inaczej na żądania do własnej domeny niż na typowe połączenia z zewnętrznymi platformami reklamowymi. Nie oznacza to jednak pełnej odporności. Ograniczenia mogą dotyczyć:- skryptów wykrywających zdarzenia,
- konkretnych adresów,
- wzorców żądań,
- plików cookie,
- polityk prywatności przeglądarki.
Server-side tracking a cookies first-party
Cookies first-party są powiązane z domeną odwiedzanej witryny. Cookies third-party występują w odmiennym kontekście domenowym i są objęte innymi ograniczeniami przeglądarek. Serwerowy pomiar może wykorzystywać odpowiednio skonfigurowane mechanizmy first-party. W niektórych architekturach serwer może również ustawiać cookies z atrybutem HttpOnly, których skrypty JavaScript nie mogą bezpośrednio odczytać. To może przynosić określone korzyści techniczne i bezpieczeństwa. Nie oznacza jednak, że cookie first-party jest automatycznie zwolnione z wymagań dotyczących zgody. Znaczenie ma cel i sposób wykorzystania technologii. Cookie potrzebne do utrzymania koszyka jest czymś innym niż identyfikator służący do profilowania reklamowego.Server-side tracking a Consent Mode v2
Consent Mode to mechanizm umożliwiający przekazywanie do systemów Google informacji o wyborach użytkownika dotyczących określonych celów pomiarowych i reklamowych. W aktualnym modelu istotne są między innymi:analytics_storage– przechowywanie danych związanych z analityką,ad_storage– przechowywanie związane z reklamą,ad_user_data– wykorzystanie danych użytkownika do celów reklamowych Google,ad_personalization– personalizacja reklam.
Server-side tracking a odmowa zgody
To jeden z najważniejszych testów całego wdrożenia. Załóżmy, że użytkownik otwiera stronę i wybiera: „Odrzuć opcjonalne”. System powinien zastosować tę decyzję zgodnie z rzeczywistą konfiguracją i wymaganiami prawnymi. Nie wystarczy ukryć banera. Nie wystarczy zapisać wyboru w cookie. Trzeba sprawdzić, jakie żądania rzeczywiście wychodzą z przeglądarki i co dzieje się później na serwerze. Jeżeli użytkownik nie wyraził wymaganej zgody na marketingowe śledzenie, backend nie powinien uruchamiać tego samego śledzenia inną drogą tylko dlatego, że ma dostęp do danych zamówienia. Pomiar serwerowy wymaga więc nie tylko konfiguracji frontendowej, ale również właściwej logiki po stronie serwera.Basic i Advanced Consent Mode
Google rozróżnia dwa podejścia do technicznej konfiguracji Consent Mode. W modelu Basic odpowiednie tagi Google pozostają zablokowane do czasu uzyskania wymaganej zgody. W modelu Advanced tagi mogą uruchamiać się wcześniej i dostosowywać zachowanie do statusu zgody, między innymi przez ograniczone sygnały bez cookies. Nie oznacza to, że model Advanced można wdrożyć bez analizy obowiązujących przepisów. Dopuszczalność konkretnych żądań trzeba oceniać w kontekście ich rzeczywistego działania, danych, celu przetwarzania i właściwych wymagań prawnych. Server-side tracking może współpracować z oboma podejściami. Nie powinien jednak samodzielnie decydować, które z nich jest zgodne z prawem w każdej sytuacji.Czy server-side tracking jest zgodny z RODO?
Może być częścią rozwiązania zaprojektowanego zgodnie z RODO i odpowiednimi przepisami dotyczącymi prywatności w komunikacji elektronicznej. Ale sam fakt przeniesienia pomiaru na serwer nie przesądza o zgodności. Trzeba ocenić między innymi:- cel zbierania danych,
- zakres identyfikatorów,
- podstawę prawną przetwarzania,
- wymagane zgody,
- odbiorców danych,
- czas przechowywania,
- sposób wycofania zgody.
Dlaczego serwer nie powinien przesyłać wszystkich danych?
Jedną z największych zalet server-side tracking jest możliwość ograniczenia informacji przekazywanych do zewnętrznych platform. Jeżeli przeglądarka wysyła dane bezpośrednio do kilku dostawców, każdy z nich otrzymuje informacje zgodnie z konfiguracją własnej integracji. Warstwa serwerowa może umożliwiać bardziej precyzyjną kontrolę. Można na przykład:- usunąć niepotrzebne parametry,
- ograniczyć zakres identyfikatorów,
- zmodyfikować strukturę zdarzenia,
- zablokować określone przekazania,
- rozdzielić dane analityczne od reklamowych.
Server-side tracking a Google Analytics 4
Google Analytics 4 opiera się na zdarzeniach. Można rejestrować między innymi:- wyświetlenia stron,
- wyświetlenia produktów,
- dodania do koszyka,
- rozpoczęcia checkoutu,
- zakupy,
- niestandardowe działania użytkowników.
Co to jest GA4 Measurement Protocol?
Measurement Protocol umożliwia wysyłanie zdarzeń do Google Analytics 4 przez żądania HTTP. Można wykorzystać go między innymi do rejestrowania wybranych interakcji po stronie serwera. Przykład: System backendowy otrzymuje informację o zdarzeniu, które nie zostało zarejestrowane przez standardowy pomiar w przeglądarce. Może przekazać odpowiednio przygotowane dane do GA4. Trzeba jednak pamiętać o istotnym ograniczeniu. Google projektuje Measurement Protocol przede wszystkim jako uzupełnienie istniejącego pomiaru za pomocą tagów lub SDK. Nie jest to pełny zamiennik całej automatycznej kolekcji danych. Samo wysłanie zdarzenia HTTP nie gwarantuje, że Google Analytics przypisze je do prawidłowego użytkownika, sesji i źródła ruchu.Server-side GTM a Measurement Protocol – czy to to samo?
Nie. Server-side GTM jest środowiskiem przetwarzania i dystrybucji zdarzeń. Measurement Protocol jest interfejsem umożliwiającym wysyłanie określonych danych do GA4. Mogą współpracować, ale nie oznaczają tego samego. Można przygotować zdarzenie backendowe wysyłane przez Measurement Protocol bez tworzenia całego serwerowego kontenera GTM. Można również wykorzystywać GTM Server do obsługi wielu różnych platform i typów zdarzeń. Wybór zależy od potrzeb. Jeżeli celem jest przesłanie kilku określonych zdarzeń biznesowych, bezpośrednia integracja może być prostsza. Jeżeli chcę zarządzać wieloma systemami pomiarowymi i regułami przekazywania danych, dodatkowa warstwa serwerowa może być uzasadniona.Co to jest Meta Conversions API?
Meta Conversions API, często określane jako CAPI, umożliwia przesyłanie zdarzeń do systemów Meta przez interfejs serwerowy. Może być wykorzystywane razem z Meta Pixel. Przykładowe zdarzenia obejmują:- wyświetlenie produktu,
- dodanie do koszyka,
- rozpoczęcie płatności,
- zakup,
- inne działania istotne dla kampanii.
Co to jest deduplikacja zdarzeń?
Deduplikacja to mechanizm rozpoznawania sytuacji, w której to samo zdarzenie zostało zarejestrowane więcej niż jeden raz. Wyobraźmy sobie zakup o numerze 12345. Przeglądarka wysyła zdarzenie Purchase. Backend również wysyła zdarzenie Purchase. Jeżeli system reklamowy potraktuje je jako dwa niezależne zakupy, raport może zawyżać wyniki. Dlatego trzeba zastosować mechanizm identyfikacji. W przypadku integracji Meta Pixel i Conversions API znaczenie mają między innymi zgodne identyfikatory zdarzeń oraz ich nazwy. Dla pojedynczego zakupu ten sam identyfikator powinien oznaczać to samo zdarzenie przekazane różnymi kanałami. Nie należy jednak przypisywać identycznego identyfikatora wszystkim zakupom. To spowodowałoby inne błędy.Dlaczego transaction_id jest ważny w GA4?
Identyfikator transakcji pomaga rozpoznawać zakupy. Przykład:transaction_id = ORDER-12345
Dobrze przygotowany system wykorzystuje stabilny, unikalny identyfikator dla konkretnej transakcji.
Ma to znaczenie dla jakości raportowania i ograniczania określonych przypadków podwójnego zliczania.
Nie oznacza to jednak, że samo dodanie transaction_id naprawia każdą możliwą duplikację.
Trzeba sprawdzić, jak zdarzenia są wysyłane i jak dany system je przetwarza.
Warto również rozdzielić identyfikatory techniczne od numerów prezentowanych klientowi, jeśli wymagają tego reguły bezpieczeństwa lub architektura sklepu.
Dlaczego nie wystarczy uruchomić Purchase na stronie podziękowania?
Strona potwierdzenia zakupu jest wygodnym miejscem do uruchamiania pomiaru. Nie zawsze stanowi jednak najlepsze źródło prawdy o zakończeniu transakcji. Możliwe są sytuacje:- klient zamknął przeglądarkę po płatności,
- strona potwierdzenia nie załadowała się,
- klient odświeżył stronę,
- płatność oczekuje na potwierdzenie,
- zamówienie zostało zapisane, ale nieopłacone.
Server-side tracking w WooCommerce
WooCommerce jest dobrym przykładem systemu, w którym warto połączyć pomiar przeglądarkowy z informacjami backendowymi. Przeglądarka może rejestrować:- oglądanie produktów,
- dodanie do koszyka,
- rozpoczęcie checkoutu.
- utworzonym zamówieniu,
- statusie płatności,
- wartości transakcji,
- użytym kodzie rabatowym,
- zmianach statusu,
- zwrotach.
Server-side tracking a operator płatności
Operator płatności może przekazywać do sklepu informację o zakończeniu transakcji. Bardzo często odbywa się to przez komunikację serwerową, na przykład webhook. To może być wartościowy sygnał dla procesu pomiarowego. Ale pojawia się ważne pytanie: czy zdarzenie powinno zostać wysłane od razu po otrzymaniu powiadomienia? Nie zawsze. Najpierw system powinien zweryfikować autentyczność komunikatu i rzeczywisty stan płatności. Następnie sprawdzić, czy dana operacja nie została już przetworzona. Dopiero wtedy można uruchomić odpowiednie działania. Nie należy pozwalać, aby każda ponowiona notyfikacja od operatora płatności tworzyła kolejne zdarzenie zakupu.Server-side tracking a leady B2B
W biznesie B2B problem pomiaru może być bardziej złożony niż w sklepie. Użytkownik wypełnia formularz. To jeszcze nie oznacza sprzedaży. Kontakt trafia do CRM. Handlowiec prowadzi rozmowę. Powstaje szansa sprzedażowa. Po kilku tygodniach klient podpisuje umowę. Klasyczny pomiar formularza nie pokazuje całej tej ścieżki. Integracja serwerowa może umożliwić przekazywanie wybranych dalszych zdarzeń z systemów firmowych, o ile istnieją odpowiednie identyfikatory, podstawa prawna i zgodna konfiguracja platform. Można wtedy analizować nie tylko liczbę formularzy. Można lepiej rozumieć, które kampanie prowadzą do wartościowych rezultatów. Ale trzeba pamiętać, że brak identyfikatorów i ograniczenia atrybucji nadal mogą uniemożliwiać przypisanie wszystkich transakcji do konkretnych reklam.Server-side tracking a Enhanced Conversions
Enhanced Conversions to mechanizm Google umożliwiający poprawę określonych aspektów pomiaru konwersji przez wykorzystanie odpowiednio przygotowanych danych użytkownika. Może obejmować informacje, takie jak adres e-mail lub inne obsługiwane dane, przetwarzane zgodnie z wymaganiami platformy. Nie należy jednak mylić haszowania danych z pełną anonimizacją. Wartości przekształcone za pomocą funkcji skrótu nadal mogą stanowić dane osobowe, jeżeli umożliwiają identyfikację lub powiązanie z osobą. Dlatego przed wdrożeniem trzeba sprawdzić wymagania prawne, ustawienia zgód oraz zasady przesyłania danych. Nie wystarczy stwierdzić: „Adres e-mail jest haszowany, więc możemy przesyłać go bez ograniczeń”.Server-side tracking a atrybucja konwersji
Atrybucja konwersjiDlaczego GA4, Google Ads i sklep mogą pokazywać inne wyniki? Każdy z tych systemów opisuje rzeczywistość z innej perspektywy. Sklep wie, jakie zamówienia zostały zapisane. Operator płatności wie, które transakcje zostały rozliczone. Google Analytics rejestruje zdarzenia według własnej konfiguracji. Google Ads przypisuje konwersje zgodnie z ustawieniami i modelem pomiaru platformy. Różnice mogą wynikać z:- definicji konwersji,
- stref czasowych,
- okien atrybucji,
- opóźnionej transmisji,
- odmowy zgody,
- brakujących identyfikatorów,
- duplikatów,
- anulowań i zwrotów.
Server-side tracking a jakość danych
Jedną z największych zalet warstwy serwerowej jest możliwość uporządkowania zdarzeń przed ich przekazaniem. Można zdefiniować wspólny model danych. Przykładowo każde zdarzenie zakupu powinno posiadać:- nazwę zdarzenia,
- unikalny identyfikator transakcji,
- wartość,
- walutę,
- czas wystąpienia,
- odpowiedni status zgody, jeżeli ma zastosowanie.
Server-side tracking a walidacja zdarzeń
Serwer może sprawdzać poprawność otrzymanych danych. Przykład: Zdarzenie Purchase nie posiada identyfikatora transakcji. Albo wartość zamówienia jest ujemna, mimo że dany typ zdarzenia nie dopuszcza takiej sytuacji. Zamiast automatycznie przesyłać błędne dane dalej, system może:- odrzucić zdarzenie,
- oznaczyć je jako wymagające weryfikacji,
- zapisać błąd techniczny,
- uruchomić odpowiedni proces naprawczy.
Czy server-side tracking poprawia szybkość strony?
Może, ale nie zawsze. Jedną z możliwych korzyści jest ograniczenie liczby skryptów i operacji wykonywanych bezpośrednio w przeglądarce. Jeżeli część logiki zostanie przeniesiona na serwer, frontend może wykonywać mniej pracy. Nie oznacza to jednak automatycznej poprawy wydajności. Jeżeli na stronie nadal działają wszystkie dotychczasowe skrypty, a dodatkowo uruchomiono kolejną warstwę pomiarową, efekt może być niewielki. Dlatego wydajność trzeba sprawdzać przed wdrożeniem i po wdrożeniu. Interesują mnie rzeczywiste parametry strony, a nie sam fakt korzystania z technologii server-side.Server-side tracking a bezpieczeństwo
Warstwa serwerowa może umożliwiać ograniczenie bezpośredniego kontaktu przeglądarki z zewnętrznymi usługami. Może również pozwalać usuwać niepotrzebne dane przed ich przekazaniem. To potencjalne korzyści. Jednocześnie powstaje nowy element infrastruktury, który trzeba zabezpieczyć. Serwer pomiarowy może odbierać duży ruch. Może przetwarzać identyfikatory. Może posiadać połączenia z zewnętrznymi API. Dlatego potrzebuje:- aktualizacji,
- bezpiecznej konfiguracji,
- kontroli dostępu,
- monitoringu,
- limitów żądań,
- ochrony danych uwierzytelniających.
Server-side tracking a ruch botów
Przeniesienie części pomiaru na serwer nie oznacza, że wszystkie odbierane zdarzenia pochodzą od rzeczywistych użytkowników. Endpoint pomiarowy może otrzymywać również:- automatyczne żądania,
- nieprawidłowe payloady,
- powtarzane zdarzenia,
- ruch testowy,
- próby nadużyć.
Ile kosztuje server-side tracking?
Koszt zależy od przyjętej architektury. Może obejmować:- hosting serwera pomiarowego,
- ruch sieciowy,
- czas procesora i pamięć,
- konfigurację domeny,
- wdrożenie integracji,
- monitoring,
- utrzymanie,
- testowanie zmian.
Czy małej firmie potrzebny jest server-side tracking?
Nie zawsze. Jeżeli niewielka strona firmowa korzysta z prostego formularza kontaktowego i podstawowego pomiaru, rozbudowany serwerowy system analityczny może nie mieć ekonomicznego uzasadnienia. Czasami znacznie więcej przyniesie:- poprawne mierzenie formularzy,
- naprawienie błędnych zdarzeń,
- uporządkowanie kampanii,
- prawidłowa konfiguracja zgód,
- połączenie leadów z CRM.
Kiedy server-side tracking ma największy sens?
Warto go rozważyć szczególnie wtedy, gdy:- sklep posiada duży wolumen transakcji,
- pomiar zakupów zależy wyłącznie od strony podziękowania,
- firma korzysta z kilku systemów reklamowych,
- potrzebna jest kontrola danych przekazywanych dostawcom,
- istnieje rozbudowany proces sprzedaży B2B,
- część istotnych zdarzeń powstaje w backendzie,
- trzeba uporządkować wiele niespójnych integracji.
Jak sprawdzić, czy obecny pomiar jest poprawny?
Przed zmianą architektury przygotowuję audyt istniejącego rozwiązania. Sprawdzam:- jakie zdarzenia są rejestrowane,
- co dokładnie je wywołuje,
- czy transakcje posiadają identyfikatory,
- czy zdarzenia nie są wysyłane podwójnie,
- jak działają zgody,
- czy raporty odpowiadają rzeczywistym procesom,
- które informacje pochodzą z przeglądarki,
- które można wiarygodniej pobrać z backendu.
Jak testować server-side tracking?
Testy powinny obejmować cały przepływ danych. Nie wystarczy sprawdzić, że serwer przyjął żądanie. Trzeba ustalić: czy zdarzenie było prawidłowe? Czy zostało poprawnie zinterpretowane? Czy przekazano je do właściwego odbiorcy? Czy nie powstał duplikat? Czy respektowano odpowiednie ustawienia zgody? Czy wynik można odnaleźć w systemie docelowym? W sklepie przygotowałbym co najmniej następujące scenariusze:- zakup opłacony prawidłowo,
- zamówienie nieopłacone,
- przerwana płatność,
- ponowione powiadomienie operatora płatności,
- odświeżenie strony podziękowania,
- zamknięcie przeglądarki po płatności,
- odmowa zgody na analitykę i marketing,
- wycofanie wcześniej udzielonej zgody.
Dlaczego wycofanie zgody musi być testowane?
Wiele implementacji sprawdza tylko dwa przypadki: użytkownik zaakceptował wszystko albo: użytkownik jeszcze nie wyraził zgody. To za mało. Użytkownik może zmienić wcześniejszą decyzję. Przykładowo początkowo akceptuje analitykę i marketing. Następnie otwiera ustawienia prywatności i wycofuje zgodę marketingową. System musi odpowiednio zaktualizować stan. Nie może zakładać, że raz uzyskana zgoda pozostaje niezmienna. W architekturze server-side trzeba sprawdzić zarówno zachowanie przeglądarki, jak i odpowiednie reguły dalszego przetwarzania. To nie jest tylko problem banera cookies. To problem całego przepływu danych.Jakie błędy najczęściej pojawiają się podczas wdrożenia?
Podwójne zdarzenia Purchase
Zakup jest wysyłany przez dotychczasowy tag webowy i nową integrację serwerową, ale nie skonfigurowano prawidłowej deduplikacji.Niepoprawne identyfikatory
Przeglądarka i serwer przekazują różne identyfikatory dla tego samego zdarzenia.Brak rozróżnienia statusów zamówienia
System traktuje utworzenie nieopłaconego zamówienia tak samo jak zakończoną płatność.Brak właściwej obsługi zgód
Frontend respektuje odmowę, ale backend nadal wysyła marketingowe zdarzenia bez odpowiedniej podstawy.Przesyłanie niepotrzebnych danych
Integracja wysyła wszystkie dostępne parametry, mimo że platforma ich nie potrzebuje.Brak testów po aktualizacjach
Zmiana w sklepie albo wtyczce powoduje nieprawidłowe zdarzenia, których nikt nie wykrywa.Brak monitoringu
Serwer pomiarowy działa, ale część żądań kończy się błędami i nie dociera do odbiorców.Oczekiwanie identycznych raportów
Firma zakłada, że Google Analytics, Google Ads i system zamówień muszą pokazywać dokładnie te same wartości.Traktowanie własnej domeny jak zwolnienia ze zgody
Techniczna zmiana adresu zbierania danych jest mylona ze zmianą obowiązków dotyczących prywatności.Server-side tracking a logowanie i monitoring
Jeżeli serwer pośredniczy w przekazywaniu zdarzeń, powinien umożliwiać kontrolę działania. Warto rejestrować odpowiednio dobrane informacje techniczne, takie jak:- typ zdarzenia,
- czas przetwarzania,
- wynik walidacji,
- system docelowy,
- status transmisji,
- informacje o błędach.
Jak ocenić efekty wdrożenia server-side tracking?
Nie ograniczałbym się do stwierdzenia: „Liczba konwersji wzrosła o 20%”. Najpierw trzeba wiedzieć, dlaczego wzrosła. Czy wcześniej zdarzenia były gubione? Czy usunięto duplikaty? Czy zmieniła się definicja zakupu? Czy równolegle zmodyfikowano kampanie? Czy liczba rzeczywistych zamówień również wzrosła? Dobrze przygotowana analiza porównuje:- dane backendowe,
- zdarzenia analityczne,
- stan zgód,
- poprawność identyfikatorów,
- liczbę błędów transmisji,
- wydajność strony,
- koszt infrastruktury.